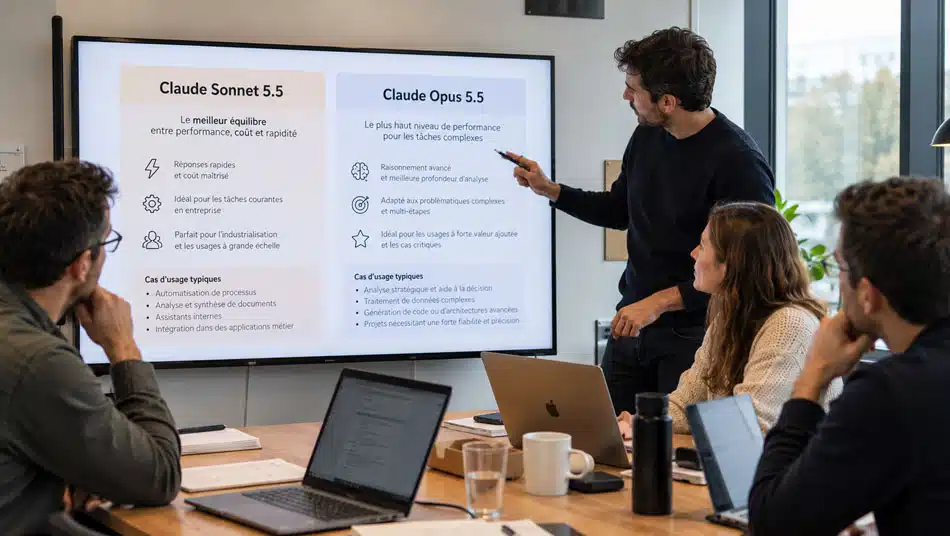
Entre Claude Sonnet 5.5 et Opus 5.5, le réflexe serait de choisir le modèle le plus puissant pour les tâches complexes et le moins cher pour les traitements courants. Sauf que dans un projet IA en entreprise, ce raisonnement peut rapidement montrer ses limites. Un modèle performant sur les benchmarks n’est pas forcément celui qui termine une tâche le plus vite. Et un LLM deux fois plus cher au million de tokens peut finalement être plus économique s’il consomme moins de ressources pour produire un résultat exploitable.
Avec Claude Sonnet 5.5 et Opus 5.5, Anthropic propose deux modèles capables de générer du code, d’analyser des documents et d’exécuter des workflows agentiques. Mais leurs performances, leur niveau de raisonnement et leur coût réel varient selon les usages. Alors, lequel choisir pour développer avec Claude Code, automatiser un processus métier ou intégrer un agent IA à son système d’information ?
Dans ce comparatif, on s’intéresse moins à la puissance théorique des modèles qu’à leur efficacité sur des tâches concrètes en entreprise : qualité des réponses, fiabilité, temps d’exécution et coût par tâche réussie.
Claude Sonnet 5.5 vs Opus 5.5 : quelles sont les principales différences ?
Claude Sonnet et Opus appartiennent à la même famille de modèles de langage développés par Anthropic, aux côtés de Haiku, pensé pour les traitements rapides à fort volume, et de Fable, orienté vers les problèmes de raisonnement particulièrement exigeants.
Les deux modèles partagent l’essentiel de leurs capacités : compréhension du langage naturel, analyse d’images et de fichiers, génération de code, utilisation d’outils (tool use) et intégration via l’API Anthropic. La différence se joue surtout sur les performances, la vitesse d’exécution et la manière dont chaque modèle mobilise son raisonnement.
| Critère | Claude Sonnet 5.5 | Claude Opus 5.5 |
| Positionnement | Équilibre entre intelligence, vitesse et coût | Travaux complexes et agents de longue durée |
| Raisonnement | Adaptatif, avec possibilité de supprimer la réflexion préalable | Adaptatif, toujours actif |
| Niveau d’effort par défaut | High | Medium |
| Latence comparative | Rapide | Modérée |
| Fenêtre de contexte | 1 million de tokens | 1 million de tokens |
| Sortie maximale | 128 000 tokens | 128 000 tokens |
| Prix API en entrée | 2 $ / million de tokens | 4 $ / million de tokens |
| Prix API en sortie | 10 $ / million de tokens | 20 $ / million de tokens |
Source : documentation officielle des modèles Claude, octobre 2026.
Premier point intéressant : les deux modèles disposent de la même fenêtre de contexte (context window) d’un million de tokens. Ils peuvent donc recevoir une quantité importante d’informations dans un même prompt, qu’il s’agisse d’une documentation technique, d’un historique de conversation ou de fichiers issus d’une base de code. Mais disposer d’un grand contexte ne signifie pas nécessairement savoir l’exploiter efficacement. La sélection et l’organisation des informations restent essentielles.
Autre différence importante : le raisonnement adaptatif (adaptive thinking). Sur Opus 5.5, il est toujours actif, alors que Sonnet permet de supprimer la réflexion préalable avec le mode between_tools, dans les configurations compatibles. Anthropic propose également plusieurs niveaux d’effort pour ajuster les ressources consacrées au raisonnement. Un paramètre à ne pas négliger : il peut modifier à la fois la qualité des réponses, la consommation de tokens et la latence.
Les benchmarks montrent d’ailleurs que le modèle le plus puissant n’est pas toujours celui qui obtient le meilleur score. Sur Terminal-Bench 4.0, une évaluation de programmation agentique, Sonnet 5.5 atteint 70,6 % contre 66,4 % pour Opus 5.5. À l’inverse, sur FrontierCode 1.1, Opus obtient 54,4 % contre 46,2 % pour Sonnet, évalué au niveau d’effort Max.
Ces résultats, publiés par Anthropic lors de la sortie de Sonnet 5.5, montrent surtout que les modèles ne sont pas évalués sur les mêmes types de problèmes et que leurs performances dépendent des configurations utilisées.
Pour choisir entre Sonnet et Opus, mieux vaut donc partir de la tâche à accomplir plutôt que du classement général des modèles.
Claude Sonnet ou Opus : quel modèle choisir selon vos cas d’usage en entreprise ?
Un chatbot de support IT, un pipeline de traitement documentaire et un agent de développement peuvent tous utiliser Claude. Pourtant, ils ne sollicitent pas les mêmes capacités. Certains processus demandent surtout des réponses rapides et reproductibles. D’autres nécessitent de prendre des décisions, de manipuler plusieurs outils ou de conserver un raisonnement cohérent pendant une longue session.
Service client et support IT : automatiser les demandes ou résoudre des incidents complexes
Pour un chatbot connecté à une base de connaissances, chargé de répondre à des questions fréquentes ou de qualifier des tickets, Sonnet est un bon candidat à tester en priorité. Le workflow reste relativement prévisible : comprendre la demande, rechercher une information, produire une réponse et, si nécessaire, transmettre le ticket à un technicien.
Prenons maintenant un incident plus complexe : une API commence à retourner des erreurs 502 après un déploiement. L’agent doit consulter les logs, examiner les modifications récentes, croiser les tickets Jira et proposer des hypothèses. Ici, le raisonnement ne se limite plus à une recherche documentaire. Opus peut devenir intéressant pour organiser les investigations et identifier les dépendances entre plusieurs composants.
Dans ce scénario, je regarderais surtout le taux de résolution sans escalade injustifiée et la pertinence des actions proposées, plutôt que la seule qualité rédactionnelle des réponses. Un diagnostic convaincant mais techniquement incorrect n’a aucune valeur, quel que soit le modèle utilisé.
RH, juridique, finance et data : du traitement documentaire à l’analyse approfondie
Extraction d’informations depuis des factures, analyse de CV, rapprochement de données ou génération de rapports : Sonnet peut parfaitement convenir aux traitements documentaires structurés. Avec un prompt précis et une sortie JSON validée par l’application, il devient possible d’automatiser des tâches répétitives tout en contrôlant la qualité des résultats.
Opus peut être intéressant lorsqu’il faut aller plus loin : comparer des clauses contractuelles contradictoires, interpréter plusieurs sources financières ou identifier des incohérences dans un dossier volumineux. Mais attention à ne pas en déduire qu’il sera toujours plus performant, ni forcément plus coûteux.
Comme l’explique ma collègue Marie Minasyan dans son article sur l’intégration de l’IA au système d’information, sur un projet interne d’analyse visuelle de documents, notre équipe a constaté qu’Opus revenait moins cher que Sonnet grâce à une consommation de tokens bien inférieure.
C’est un exemple intéressant : le modèle affichant le prix unitaire le plus élevé a finalement présenté le meilleur coût sur ce traitement précis. Les versions testées n’étant pas détaillées, ce constat ne constitue pas un benchmark des modèles 5.5. Il montre néanmoins pourquoi il faut mesurer le coût complet du traitement, plutôt que se fier uniquement à la grille tarifaire d’Anthropic.
Développement logiciel et Claude Code : quel modèle choisir pour coder ?
Selon la Stack Overflow Developer Survey 2026, 65,9 % des 17 464 répondants à la question sur les usages professionnels de l’IA utilisent des assistants de programmation ou des agents de coding. La question n’est donc plus seulement de savoir si l’IA peut produire du code, mais jusqu’où lui déléguer le travail.
Avec Claude Code, Sonnet 5.5 est intéressant pour les tâches de développement courantes : implémenter une fonctionnalité ciblée, générer des tests unitaires, corriger un bug localisé ou effectuer un refactoring limité. Sur un projet correctement structuré, avec des conventions documentées dans CLAUDE.md et une suite de tests automatisés en CI/CD avec Claude Code, il peut aussi prendre en charge des modifications plus importantes.
Pour une migration applicative ou un problème impliquant plusieurs services, Opus mérite d’être comparé. Il peut être utile pour analyser les dépendances, construire un plan d’implémentation et maintenir la cohérence des changements sur une base de code étendue.
Mais je ne choisirais pas Opus simplement parce que la tâche concerne l’architecture. Je regarderais d’abord le comportement de chaque modèle sur le repository : combien de fichiers modifiés, combien de tests réussis, combien de corrections nécessaires et, surtout, si la modification respecte les conventions du projet.
Une approche possible consiste à confier la planification à Opus et les changements ciblés à Sonnet. Ce n’est toutefois pas une règle : si Sonnet termine correctement le travail de bout en bout, ajouter un second modèle ne fera que complexifier le workflow.
Agents IA métier : exécuter des workflows ou orchestrer des tâches complexes
Avec les agents IA Claude, le modèle ne produit plus seulement une réponse. Il peut interroger une API, récupérer des informations dans un CRM, consulter une base documentaire ou déclencher des actions à travers des outils connectés au système d’information, notamment via MCP (Model Context Protocol).
Pour un processus bien défini, comme qualifier une demande RH ou préparer un dossier client, Sonnet peut suffire. L’application conserve la logique métier, les permissions et les règles de validation, tandis que le modèle intervient sur les étapes nécessitant une compréhension du langage naturel.
Opus devient intéressant lorsque l’agent doit choisir lui-même les prochaines actions, interpréter des résultats inattendus ou poursuivre un objectif sur plusieurs étapes. Ces tâches long horizon exigent davantage de planification et une gestion rigoureuse du contexte entre les appels d’outils.
Le piège serait cependant d’associer automatiquement agent autonome et modèle le plus puissant. Un workflow bien conçu, avec peu d’actions et des résultats vérifiables, sera souvent plus simple à fiabiliser qu’un système multi-agents inutilement sophistiqué.
Pour résumer, voici les premiers modèles à évaluer selon les usages :
| Cas d’usage | Modèle à tester | Ce qui doit départager les modèles |
| Chatbot et support IT courant | Sonnet | Temps de réponse, taux de résolution |
| Diagnostic d’incidents complexes | Opus | Pertinence du diagnostic et des actions |
| Extraction documentaire | Sonnet et Opus | Précision, tokens et coût par document |
| Analyse multi-documents | Opus | Cohérence, erreurs et vérifiabilité |
| Génération de code et tests | Sonnet | Tests réussis, corrections nécessaires |
| Migration applicative | Sonnet et Opus | Qualité des modifications et dépendances |
| Agent métier à workflow cadré | Sonnet | Taux de réussite et coût |
| Agent à tâches complexes | Opus ou combinaison | Autonomie, erreurs et reprise d’exécution |
Ces recommandations sont des hypothèses de départ. Elles permettent d’identifier les modèles à comparer, mais pas de valider un choix de production sans évaluation.
Combien coûtent Claude Sonnet et Opus pour une entreprise ?
Avec l’API Anthropic, la tarification repose principalement sur les tokens d’entrée (input tokens) et de sortie (output tokens). Opus 5.5 coûte deux fois plus cher que Sonnet 5.5 à volume identique, mais ce volume dépend du comportement du modèle, de la longueur du contexte et des appels d’outils nécessaires pour terminer la tâche.
| Tarification API | Sonnet 5.5 | Opus 5.5 |
| 1 million de tokens d’entrée | 2 $ | 4 $ |
| 1 million de tokens de sortie | 10 $ | 20 $ |
| 1 million de tokens lus depuis le cache | 0,10 $ | 0,20 $ |
| 1 million de tokens d’entrée via Batch API | 1 $ | 2 $ |
| 1 million de tokens de sortie via Batch API | 5 $ | 10 $ |
Source : tarification officielle Anthropic, octobre 2026. Tarifs standards en dollars, hors éventuels frais supplémentaires.
Prenons une application qui traite 50 000 requêtes par mois, avec en moyenne 3 000 tokens d’entrée et 500 tokens de sortie par appel. À consommation strictement identique, le coût API serait d’environ 550 $ avec Sonnet contre 1 100 $ avec Opus. Cette simulation inclut les tokens de raisonnement dans le volume de sortie et exclut les frais d’infrastructure, les outils payants et les mécanismes de cache.
Sauf que cette hypothèse d’une consommation identique est rarement garantie. Un modèle peut multiplier les tentatives, générer davantage de tokens de raisonnement ou répéter des appels d’outils. À l’inverse, un autre peut résoudre la tâche en moins d’étapes.
C’est pourquoi je privilégierais le coût par tâche validée plutôt que le prix par requête. Pour une comparaison pertinente, il faut rapporter l’ensemble des tokens consommés au nombre de tâches réellement réussies, puis intégrer les coûts de vérification et de correction.
Cette approche rejoint les travaux publiés par McKinsey en octobre 2026 sur l’économie de l’IA : l’intérêt financier d’une automatisation dépend du coût complet de la tâche, y compris les interventions humaines nécessaires pour contrôler et reprendre les résultats.
Plusieurs mécanismes permettent ensuite d’optimiser les dépenses. Le prompt caching évite de refacturer au tarif standard les parties de contexte réutilisées, la Batch API réduit de 50 % le prix des tokens pour les traitements asynchrones et les niveaux d’effort permettent d’adapter les ressources consacrées au raisonnement. Sur les applications à fort volume, il faut également surveiller les rate limits et la consommation de tokens générée par les outils.
Mais ces optimisations ne doivent intervenir qu’après avoir mesuré le comportement réel du modèle. Un prompt plus court n’est pas forcément plus économique s’il entraîne davantage d’erreurs ou de nouvelles tentatives.
Quels critères prendre en compte pour choisir entre Claude Sonnet et Opus ?
Avant de sélectionner un modèle pour une application métier, il faut définir ce qu’on attend concrètement de lui. Trois critères permettent de construire une comparaison qui ait du sens, au-delà des benchmarks Anthropic.
La complexité des tâches et le niveau d’autonomie attendu
La première question est simple : le modèle doit-il appliquer des instructions ou décider comment atteindre un résultat ?
Extraire des informations dans un format prédéfini, classifier un document ou générer une réponse à partir d’une procédure sont des tâches relativement cadrées. À l’inverse, diagnostiquer un incident inconnu ou conduire une modification logicielle à travers plusieurs repositories suppose de sélectionner des outils, d’interpréter leurs résultats et d’adapter les prochaines actions.
La complexité ne dépend pas du nombre d’étapes, mais des décisions à prendre entre ces étapes. C’est cette distinction qui permet de déterminer si les capacités de raisonnement d’Opus apportent un bénéfice réel ou si Sonnet suffit, éventuellement avec un niveau d’effort adapté.
La fiabilité des résultats et les risques métier
Une IA qui produit une réponse approximative dans un assistant interne ne présente pas les mêmes risques qu’un agent capable de modifier du code ou d’exécuter une opération dans un logiciel métier.
D’après la Stack Overflow Developer Survey 2026, 48 % des répondants déclarent faire confiance aux résultats de l’IA lorsqu’ils peuvent facilement les vérifier, contre seulement 6,6 % lorsqu’il s’agit notamment de décisions professionnelles importantes. Ces résultats concernent les outils IA en général, mais rappellent l’importance de la validation.
Sur les tâches sensibles, je regarderais donc autant la capacité du modèle à reconnaître ses limites que la pertinence de ses réponses. Un LLM qui exprime une incertitude et demande une validation peut être préférable à un modèle qui propose une action erronée avec assurance.
Les contrôles restent indispensables : validation des sorties structurées, tests automatisés, gestion des permissions, traçabilité des appels d’outils et supervision humaine (human review). Opus peut améliorer la qualité du raisonnement, mais il ne remplace ni les règles métier ni les garde-fous de l’application.
Le volume de requêtes et le temps de réponse attendu
Dernier critère : les conditions d’exploitation. Un chatbot utilisé toute la journée doit répondre rapidement et respecter des contraintes de latence. Un agent chargé d’analyser une architecture logicielle peut accepter un temps de traitement plus long si le résultat est fiable.
Il faut surtout distinguer la latence du premier token (time to first token) du temps total nécessaire pour terminer le workflow. Dans une architecture agentique, le temps d’exécution comprend également les appels API, les outils utilisés, les tentatives supplémentaires et les éventuelles validations.
Pour départager Sonnet et Opus, je mettrais donc en place un test comparatif sur un jeu de tâches représentatif. Par exemple, pour un agent de support IT, on pourrait constituer un corpus de 30 tickets anonymisés comprenant des demandes simples, des incidents connus et quelques situations ambiguës.
L’objectif serait de comparer les deux modèles avec les mêmes outils, les mêmes données et des niveaux d’effort explicitement documentés. Chaque scénario serait exécuté plusieurs fois pour mesurer la variabilité des réponses.
Quatre indicateurs permettraient alors d’arbitrer : le taux de réussite, le temps total d’exécution, le coût par tâche validée et le nombre d’interventions humaines nécessaires. On disposerait ainsi d’une base concrète pour choisir le modèle, plutôt que d’une simple préférence fondée sur les performances annoncées par l’éditeur.
Peut-on combiner Claude Sonnet et Opus dans une même application ?
Dans certains projets, il peut être intéressant d’utiliser Sonnet et Opus au sein d’une même application plutôt que d’imposer un modèle unique à tous les traitements.
Prenons un agent chargé de traiter des demandes fournisseurs. Sonnet peut extraire les informations des documents reçus et vérifier leur conformité avec des règles métier. Lorsqu’une incohérence complexe apparaît, l’application peut orienter le dossier vers Opus pour une analyse complémentaire, avant validation humaine.
Cette approche repose sur un mécanisme de routage des modèles (model routing). Une couche applicative sélectionne Sonnet ou Opus selon la nature de la requête, les résultats des premières vérifications ou le niveau de raisonnement attendu. Elle ne nécessite pas forcément plusieurs agents : un routeur peut simplement choisir le modèle auquel envoyer un appel API.
Dans une architecture multi-agents, différents agents spécialisés peuvent également prendre en charge la planification, l’exécution ou la revue des résultats. L’intégration peut s’appuyer sur l’API Claude, le Claude Agent SDK et des outils métier accessibles via API ou serveurs MCP.
Attention cependant à la gestion du contexte entre les modèles. Les blocs de raisonnement internes (thinking blocks) de Claude Opus 5.5 ne sont pas directement réutilisables par Sonnet 5.5. L’application doit donc préserver les informations nécessaires au workflow et organiser correctement la transmission des résultats. La documentation de migration d’Anthropic précise ces contraintes.
Une architecture multi-modèles ajoute également des appels API, de la latence et des besoins d’observabilité. Avant de la mettre en place, il faut vérifier qu’elle apporte un gain mesurable par rapport à un seul modèle correctement configuré.
La bonne architecture n’est pas celle qui utilise le plus d’agents ou de modèles, mais celle qui accomplit le travail attendu avec le moins de complexité inutile.
Claude Sonnet ou Opus : le bon modèle dépend de votre usage
Sonnet 5.5 et Opus 5.5 répondent à des besoins complémentaires, mais aucun ne constitue le meilleur choix dans toutes les situations. Les différences de performance, de latence et de tarification sont importantes, mais elles ne suffisent pas à déterminer quel modèle sera le plus efficace sur un projet réel.
La bonne approche consiste à partir de la tâche, comparer les résultats, mesurer le coût complet et adapter le modèle au niveau de complexité réellement nécessaire. C’est aussi ce qui permet de savoir si une combinaison Sonnet/Opus présente un intérêt ou si un modèle unique suffit.
Chez Eleven Labs, agence Claude, nous accompagnons les entreprises dans cette démarche, du choix des modèles Claude à leur intégration dans le système d’information et leur industrialisation. En tant que Select Partner Anthropic, nous mobilisons nos experts Claude et nos expertises en développement logiciel, architecture SI et agents IA pour concevoir des solutions fiables, sécurisées et adaptées aux usages métier.
Quel modèle Claude pour votre projet IA ?
Sonnet, Opus ou une combinaison des deux ? Nos experts certifiés Claude vous accompagnent pour évaluer les modèles sur vos cas d’usage, choisir la bonne architecture et intégrer votre solution IA en production.