Et si vos pipelines CI/CD pouvaient faire plus que simplement exécuter des scripts et lancer des tests ? Avec Claude Code, l’agent IA d’Anthropic, il est possible d’automatiser des tâches qui nécessitent une véritable compréhension du code : analyser une pull request, identifier l’origine d’un test échoué, proposer des corrections ou encore mettre à jour la documentation technique.
Et bonne nouvelle, l’intégration de Claude Code se fait directement dans vos workflows GitHub Actions et GitLab CI/CD. Grâce à son mode headless, il peut s’exécuter sans interaction humaine, à partir d’instructions définies à l’avance. L’idée n’est pas de remplacer vos outils DevOps, mais d’aller plus loin dans l’automatisation de vos processus de développement.
C’est d’ailleurs un sujet que j’ai dû maîtriser pour obtenir ma certification Claude Certified Architect – Foundations. L’intégration de Claude Code dans les workflows CI/CD fait partie du domaine 3 de l’examen, consacré à la configuration et aux flux de travail de Claude Code, qui représente 20% de la note finale.
Dans ce guide, je vous explique comment utiliser Claude Code en mode headless, l’intégrer dans vos pipelines CI/CD et exécuter des automatisations concrètes. Avec, bien sûr, les bonnes pratiques pour garder la maîtrise de la sécurité, des coûts et de la qualité du code.
Claude Code en CI/CD : fonctionnement et possibilités d’automatisation
Dans un pipeline CI/CD classique, chaque étape suit des règles définies à l’avance : compiler le code, exécuter les tests, vérifier sa qualité ou déclencher un déploiement via un job. C’est efficace pour des tâches prévisibles, mais dès qu’un problème nécessite d’interpréter du code ou de comprendre pourquoi un test échoue, un développeur doit généralement intervenir.
Claude Code vient compléter cette automatisation en apportant une capacité d’analyse et de raisonnement sur le code. Plutôt que de se limiter à l’exécution d’un script, l’agent peut explorer un repository Git, comprendre les modifications apportées à un projet logiciel, analyser des erreurs et proposer des actions adaptées au contexte.
Prenons un exemple simple : un développeur ouvre un pull request sur GitHub. Le pipeline lance les tests habituels, mais déclenche également Claude Code pour analyser les changements. L’agent examine les fichiers modifiés, recherche d’éventuelles incohérences et peut publier ses recommandations directement dans la pull request. Le développeur dispose ainsi d’un premier retour avant même de solliciter une revue humaine.
Et ce n’est qu’un exemple. Selon les outils, les permissions et la configuration du workflow, Claude Code peut intervenir à différentes étapes du cycle de développement.
| Cas d’usage | Ce que fait Claude Code | Résultat attendu |
| Revue de code | Analyse les modifications d’une pull request ou merge request | Identifie des bugs potentiels et propose des améliorations |
| Analyse des tests échoués | Examine les logs d’erreur et le code concerné | Identifie les causes probables et suggère des corrections |
| Génération de tests | Analyse une fonctionnalité ou des modifications de code | Propose des tests unitaires ou d’intégration supplémentaires |
| Documentation technique | Identifie les changements apportés au projet | Génère ou actualise la documentation associée |
| Traitement des issues | Analyse une issue GitHub ou GitLab et explore le dépôt | Prépare une proposition de modification sur une branche dédiée |
| Maintenance du code | Repère les portions de code complexes ou répétitives | Suggère des refactorings et des améliorations |
Ces tâches peuvent être déclenchées automatiquement à partir d’événements précis : un nouveau commit, l’ouverture d’une merge request, l’échec d’un job ou encore une exécution planifiée.
Pour autant, intégrer Claude Code ne signifie pas lui confier les clés de tout le pipeline. L’agent intervient dans un périmètre défini par son prompt, les permissions accordées et les outils auxquels il peut accéder. Les tests automatisés, les règles de sécurité et les validations humaines restent en place.
C’est justement ce qui rend l’approche intéressante : on ne cherche pas à remplacer un pipeline CI/CD qui fonctionne déjà, mais à lui ajouter des capacités là où l’analyse humaine constitue habituellement un point de passage.
Reste une question technique essentielle : comment faire fonctionner Claude Code dans un pipeline sans qu’il attende une instruction ou une autorisation dans le terminal ? C’est là qu’intervient le mode headless.
Exécuter Claude Code en mode headless dans un pipeline CI/CD
Pour intégrer Claude Code à un pipeline CI/CD, il faut pouvoir lancer l’agent sans qu’un développeur ait besoin d’interagir avec lui. C’est exactement ce que permet le mode headless, aussi appelé mode non interactif.
Contrairement à une session Claude Code classique, dans laquelle vous échangez avec l’agent depuis votre terminal, le mode headless permet de lui transmettre un prompt, de le laisser exécuter les tâches autorisées et de récupérer automatiquement son résultat. Le tout depuis un script, un job GitHub Actions ou un pipeline GitLab CI/CD.
Le fonctionnement repose sur une commande simple, avec le flag : claude -p (--print).Prenons un premier exemple. Vous souhaitez demander à Claude Code d’analyser le module d’authentification de votre application, sans modifier les fichiers du projet :
claude -p "Analyse le module d'authentification et identifie les problèmes potentiels de sécurité." \
 --tools "Read,Grep,Glob" \
 --permission-mode dontAsk
Configurer les permissions et le contexte de l’agent
L’un des points importants avec le mode headless, c’est de définir précisément ce que Claude Code est autorisé à faire. Dans un pipeline automatisé, on ne peut pas compter sur un développeur pour accepter ou refuser chaque demande d’autorisation.
Claude Code dispose pour cela de plusieurs options de configuration :
| Paramètre | Utilité |
| -p ou –print | Exécute Claude Code sans session interactive |
| –allowedTools | Autorise certains outils sans demande de confirmation (ne retire pas les autres) |
| –output-format json | Retourne le résultat et les métadonnées au format JSON |
| –json-schema | Définit la structure attendue pour le résultat |
| –max-turns | Limite le nombre de tours de l’agent |
| –max-budget-usd | Fixe un plafond de coût pour l’exécution |
| –bare | Réduit les éléments chargés automatiquement au démarrage |
| –tools | Restreint la liste des outils disponibles pour l’agent |
| –permission-mode dontAsk | Refuse automatiquement toute action qui nécessiterait une confirmation |
Par exemple, pour une simple revue de code, inutile d’autoriser Claude Code à modifier les fichiers ou à exécuter des commandes système. Attention toutefois : –allowedTools « Read » ne fait qu’éviter la confirmation pour l’outil Read, il ne retire pas les autres outils. Pour une exécution réellement en lecture seule, combinez –tools « Read,Grep,Glob » (liste restreinte) et –permission-mode dontAsk (refus automatique de tout ce qui demanderait une autorisation).
Le fichier de configuration CLAUDE.md, ainsi que les fichiers .claude/rules jouent également un rôle important. Placés dans le repository, ils permettent de transmettre à l’agent les conventions de développement, les règles d’architecture ou les instructions spécifiques au projet. Claude Code peut ainsi réaliser ses analyses en tenant compte de votre contexte technique, plutôt que de formuler des recommandations génériques.
À noter : l’option –bare, recommandée par Anthropic pour les scripts et la CI, désactive le chargement automatique de CLAUDE.md, des Skills, des hooks, des sous-agents, des plugins, des serveurs MCP et de la mémoire automatique. Elle ne lit pas non plus les identifiants OAuth : une clé ANTHROPIC_API_KEY devient obligatoire. Le contexte nécessaire doit alors être passé explicitement (–settings, –mcp-config, –append-system-prompt…). Anthropic annonce que ce comportement deviendra celui de -p par défaut dans une prochaine version.
Récupérer des résultats JSON exploitables dans le pipeline
L’autre avantage du mode headless, c’est de pouvoir récupérer les réponses de Claude Code dans un format structuré (structured output). C’est particulièrement utile lorsqu’une étape du pipeline doit exploiter le résultat d’une analyse pour déclencher une autre action.
Imaginons que vous souhaitiez analyser un fichier et récupérer la liste des fonctions qu’il contient :
claude -p "Identifie les fonctions principales de auth.py" \
 --tools "Read,Grep,Glob" \
 --permission-mode dontAsk \
 --output-format json \
 --json-schema '{"type":"object","properties":{"functions":{"type":"array","items":{"type":"string"}}},"required":["functions"]}'
Avec –json-schema, vous définissez précisément le format attendu. Claude Code renvoie une réponse JSON contenant les métadonnées d’exécution et un champ structured_output, dont le contenu pourrait ressembler à ceci :
{
 "functions": [
   "authenticate_user",
   "verify_token",
   "refresh_session"
 ]
}
Exemple fictif du contenu du champ structured_output, dépendant du code analysé.
Ce résultat peut ensuite être récupéré par un script, lu avec un outil comme jq ou transmis à un autre job du pipeline.
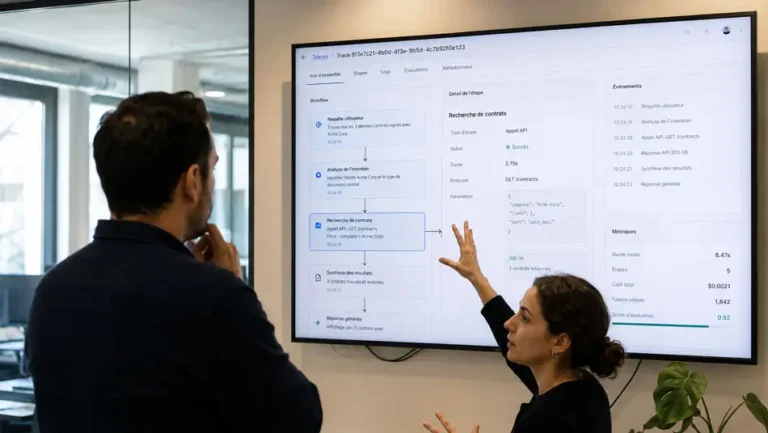
Exemple de déroulement d’une exécution headless
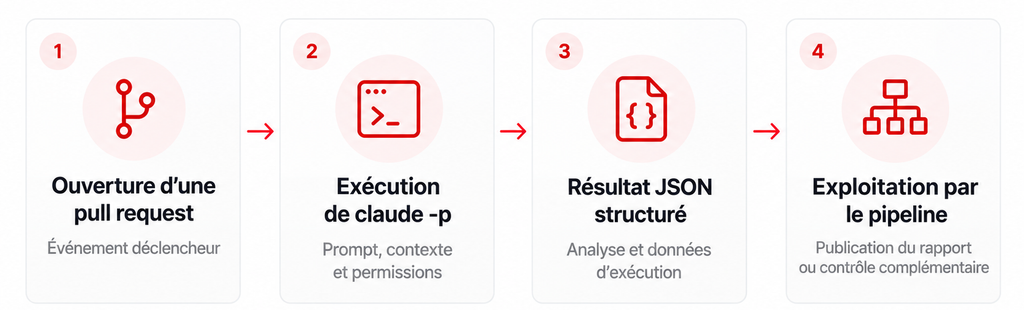
Attention toutefois : obtenir une réponse JSON valide ne signifie pas que l’analyse est correcte. Il faut toujours contrôler les données retournées et gérer les éventuels échecs d’exécution.
Le mode headless constitue donc la base d’une intégration automatisée de Claude Code. Une fois les commandes, les permissions et les formats de sortie définis, il reste à les intégrer dans un véritable workflow CI/CD. C’est ce que nous allons voir avec GitHub Actions et GitLab CI/CD.
Intégrer Claude Code à GitHub Actions et GitLab CI/CD
Maintenant que nous avons vu comment exécuter Claude Code en mode headless, passons à la pratique : comment l’intégrer dans un véritable pipeline CI/CD ?
Deux possibilités s’offrent à vous : utiliser une intégration dédiée ou exécuter directement Claude Code dans un job personnalisé. Dans les deux cas, le principe reste le même : un événement déclenche le workflow, Claude Code récupère le contexte du projet, exécute les tâches autorisées et renvoie son résultat. Pour des workflows plus complexes, l’Agent SDK (TypeScript et Python) offre un équivalent programmatique de claude -p, avec les mêmes options de permissions et de sortie structurée.
Avant de commencer, quelques prérequis sont nécessaires : disposer d’un dépôt Git, d’un environnement d’exécution compatible, d’un accès à Claude (via l’API Anthropic ou un fournisseur cloud comme Amazon Bedrock ou Google Cloud) et des permissions suffisantes pour configurer les workflows.
Configurer Claude Code avec GitHub Actions
GitHub dispose d’une intégration officielle, Claude Code GitHub Action, qui permet d’exécuter l’agent directement dans les workflows de votre repository. Vous pouvez notamment demander à Claude d’intervenir sur une issue, d’analyser une pull request ou de proposer des modifications à partir d’un commentaire.
La méthode la plus simple consiste à lancer Claude Code depuis le terminal de votre projet et à exécuter :
/install-github-appCette commande, à lancer dans une session interactive Claude Code, vous accompagne dans l’installation de la GitHub App, la configuration de l’authentification et la création des fichiers de workflow. Elle nécessite notamment des droits d’administration sur le dépôt et la GitHub CLI.
Vous pouvez également procéder manuellement. Il faut alors installer la Claude GitHub App, enregistrer votre clé API Anthropic dans les secrets GitHub sous le nom ANTHROPIC_API_KEY, puis créer un fichier YAML dans le répertoire .github/workflows/.
Si vous disposez d’un abonnement Claude Pro ou Max, vous pouvez générer un token avec claude setup-token et le stocker dans le secret CLAUDE_CODE_OAUTH_TOKEN (input claude_code_oauth_token) à la place de la clé API. Pour un secret partagé entre plusieurs dépôts, Anthropic recommande la clé API.
Prenons un exemple simple : déclencher une revue de code avec Claude Code à chaque ouverture ou mise à jour d’une pull request.
name: Claude Code Review
on:
  pull_request:
    types: [opened, synchronize, reopened, ready_for_review]
jobs:
  review:
    runs-on: ubuntu-latest
permissions:
      contents: read
      pull-requests: read
      issues: read
      id-token: write
steps:
      - uses: actions/checkout@v6
        with:
          fetch-depth: 1
- uses: anthropics/claude-code-action@v1
        with:
          anthropic_api_key: ${{ secrets.ANTHROPIC_API_KEY }}
          plugin_marketplaces: "https://github.com/anthropics/claude-code.git"
          plugins: "code-review@claude-code-plugins"
          prompt: "/code-review:code-review --comment ${{ github.repository }}/pull/${{ github.event.pull_request.number }}"
          claude_args: '--allowedTools "mcp__github_inline_comment__create_inline_comment"'
Concrètement, lorsque le développeur ouvre ou met à jour une pull request, GitHub Actions déclenche le job review. Claude Code utilise ici le plugin de revue de code pour analyser les modifications et publier ses observations directement sur la PR.
Quelques éléments méritent votre attention : actions/checkout récupère le repository, anthropic_api_key permet l’authentification sans exposer la clé dans le fichier YAML, id-token: write est requis par l’action pour l’authentification via la GitHub App (et pour la fédération d’identité vers un cloud provider) et claude_args autorise l’outil MCP utilisé pour publier les commentaires de code review.
Vous pouvez aussi utiliser Claude Code à la demande. Avec un workflow configuré pour réagir aux mentions, un développeur peut simplement écrire dans un commentaire :
@claude analyse cette pull request et identifie les risques de régression.L’agent reçoit alors la demande, analyse le contexte accessible et renvoie son résultat dans la discussion. Ce déclenchement nécessite un workflow sur les événements issue_comment / pull_request_review_comment. Par défaut, seuls les utilisateurs disposant de droits d’écriture sur le dépôt peuvent déclencher l’agent ; les inputs allowed_non_write_users et allowed_bots permettent d’élargir cette liste, et trigger_phrase de changer le mot-clé.
Mon conseil : commencez avec une automatisation de revue de code sur un repository de test. C’est un bon moyen de vérifier la pertinence des analyses, la consommation de tokens et les permissions avant de généraliser l’intégration.
Configurer Claude Code avec GitLab CI/CD
Avec GitLab, le principe est similaire, mais la configuration passe par le fichier .gitlab-ci.yml et les variables CI/CD du projet.
L’intégration Claude Code pour GitLab CI/CD est encore présentée comme une fonctionnalité bêta dans la documentation officielle. Elle permet néanmoins d’exécuter Claude Code dans les GitLab Runners et d’automatiser plusieurs tâches, notamment l’analyse de merge requests et la proposition de modifications.
Pour commencer, rendez-vous dans les paramètres de votre projet GitLab, puis dans Settings → CI/CD → Variables. Ajoutez votre clé API Anthropic sous le nom ANTHROPIC_API_KEY, en activant l’option de masquage et, lorsque c’est adapté, la protection de la variable.
Vous pouvez ensuite ajouter un job dédié à Claude Code dans votre fichier .gitlab-ci.yml.
Voici un exemple volontairement simple, qui déclenche une analyse lors d’une merge request ou d’une exécution manuelle du pipeline.
stages:
 - ai
claude-review:
  stage: ai
  image: node:24-alpine3.21
rules:
    - if: '$CI_PIPELINE_SOURCE == "merge_request_event"'
    - if: '$CI_PIPELINE_SOURCE == "web"'
before_script:
    - apk add --no-cache git curl bash
    - npm install -g @anthropic-ai/claude-code
    - curl -fsSL https://claude.ai/install.sh | bash
    - export PATH="$HOME/.local/bin:PATH"
    - git fetch origin "$CI_MERGE_REQUEST_TARGET_BRANCH_NAME" --depth=50
script:
    - |
      claude -p \
        "Analyse uniquement les modifications visibles dans git diff origin/$CI_MERGE_REQUEST_TARGET_BRANCH_NAME...HEAD », avec --tools "Read,Grep,Glob,Bash" et --allowedTools "Bash(git diff:*)"\
        --permission-mode dontAsk \
        --max-turns 5 \
        --output-format json > claude-review.json
artifacts:
    paths:
      - claude-review.json
    when: always
Ici, le fonctionnement est assez direct. À chaque événement de merge request, GitLab lance le job claude-review, installe Claude Code, puis exécute l’analyse en mode headless.
Le résultat est enregistré dans un fichier claude-review.json, conservé comme artifact du pipeline et consultable depuis la vue du job GitLab. Un développeur peut ensuite le consulter ou une autre étape automatisée peut l’exploiter.
L’exemple ne publie pas de commentaires dans la MR ; pour cela il faudra appeler l’API GitLab depuis le script avec le résultat JSON.
Pour aller plus loin, GitLab permet également de connecter Claude Code à Amazon Bedrock ou à Google Cloud via des mécanismes d’identité fédérée comme OIDC et Workload Identity Federation, avec une gestion des rôles IAM ou des service accounts selon le cloud provider. C’est particulièrement intéressant lorsque l’entreprise souhaite utiliser son infrastructure cloud et éviter de stocker des identifiants permanents dans ses variables CI/CD.
GitHub Actions ou GitLab CI/CD : quelle intégration privilégier ?
Les deux plateformes permettent d’automatiser des tâches avec Claude Code et d’orchestrer les jobs, mais leur mise en œuvre présente quelques différences.
| Critère | GitHub Actions | GitLab CI/CD |
| Configuration | Fichiers .github/workflows/*.yml | Fichier .gitlab-ci.yml |
| Intégration Claude Code | GitHub Action officielle | Intégration GitLab en bêta ou job personnalisé |
| Déclenchement | Pull requests, issues, commentaires, événements GitHub | Merge requests, pipelines, déclenchements manuels ou via API |
| Authentification | Secrets GitHub, OAuth ou fédération d’identité | Variables CI/CD ou fédération d’identité |
| Exécution | GitHub Actions Runners | GitLab Runners |
| Fournisseurs cloud | API Claude, Amazon Bedrock, Google Cloud et autres fournisseurs compatibles | API Claude, Amazon Bedrock, Google Cloud |
| Résultats | Logs, commentaires PR, modifications ou artifacts selon le workflow | Logs, artifacts, modifications ou commentaires MR selon l’intégration |
Au final, il n’est pas nécessaire de changer de plateforme CI/CD pour utiliser Claude Code. Le plus simple reste de partir de votre environnement actuel et d’y intégrer progressivement les automatisations qui ont le plus de valeur pour vos équipes.
Une fois cette première intégration fonctionnelle, vous pouvez aller plus loin que la simple revue de code. Analyse de tests échoués, génération de documentation, traitement automatique d’issues… Voyons maintenant quatre workflows concrets à mettre en place avec Claude Code.
4 exemples de workflows CI/CD à automatiser avec Claude Code
Maintenant que Claude Code est intégré à votre pipeline, qu’est-ce qu’on peut réellement lui faire faire ? Beaucoup de choses, mais tous les cas d’usage ne se valent pas.
Je vous conseille de commencer par les tâches répétitives qui demandent une analyse du code, sans pour autant nécessiter qu’un développeur prenne systématiquement la main. Revue de pull requests, investigation après l’échec d’un test, génération de documentation… Voici quatre workflows intéressants à mettre en place avec Claude Code.
1. Automatiser la revue de code des pull requests et merge requests
C’est probablement l’un des premiers cas d’usage à expérimenter. À chaque ouverture ou mise à jour d’une pull request GitHub ou merge request GitLab, Claude Code peut analyser les modifications et signaler les problèmes potentiels avant la revue humaine.
Imaginons qu’un développeur modifie le système d’authentification d’une application. Claude Code peut examiner le diff Git, identifier des erreurs de logique, repérer un contrôle de permissions manquant ou signaler un risque de régression.
Pour cadrer son analyse, vous pouvez lui transmettre un prompt comme celui-ci :
Analyse les modifications de cette pull request.
Concentre-toi sur :
- Les bugs et erreurs de logique
- Les risques de régression
- Les problèmes de sécurité
- Les incohérences avec les conventions du projet
Pour chaque problème identifié, indique :
- Le fichier et la ligne concernés
- Le problème détecté
- Son niveau de gravité
- Une proposition de correction
Ignore les remarques purement stylistiques.
Ne modifie aucun fichier.
L’idée n’est pas de demander à Claude Code de commenter chaque ligne, mais de faire remonter les problèmes qui méritent réellement l’attention du développeur.
Sur les pull requests plus complexes, vous pouvez aller plus loin avec une revue multi-passes : une première analyse des fichiers modifiés, une deuxième sur leurs interactions avec le reste de l’application, puis une synthèse des anomalies détectées.
On peut également isoler la session chargée de générer du code de celle qui effectue la review, afin d’obtenir une code review indépendante.
Résultat attendu : un rapport ou des commentaires contextualisés dans la PR/MR, que les développeurs peuvent examiner avant le merge.
L’idée n’est pas de remplacer la revue humaine, mais d’assurer que la PR/MR est réellement prête et fonctionnelle avant de solliciter les collègues.
2. Analyser les tests échoués et proposer des corrections
Autre scénario intéressant : faire intervenir Claude Code lorsqu’un job CI échoue.
Habituellement, un développeur doit ouvrir les logs, identifier le test responsable de l’échec, remonter jusqu’au code concerné, puis chercher une solution. Claude Code peut automatiser une partie de cette investigation.
Prenons un exemple. Votre pipeline exécute les tests unitaires et retourne cette erreur :
FAILED tests/test_auth.py::test_token_expiration
AssertionError:
Expected status code: 401
Received status code: 200
Au lieu de simplement signaler que le test a échoué, un job dédié peut transmettre le log à Claude Code pour lui demander d’analyser le problème.
claude -p \
 "Analyse l'échec du test dans test-results.log.
  Identifie la cause probable dans le code.
  Propose une correction sans modifier les fichiers." \
 --tools "Read,Grep,Glob" --permission-mode dontAsk \
 --max-turns 5
Cet exemple suppose que le fichier test-results.log est disponible dans l’environnement du job. –tools limite l’agent aux outils de lecture et –permission-mode dontAsk refuse automatiquement toute action non autorisée, sans attendre une validation qui n’arrivera jamais dans un pipeline.
Claude Code peut alors explorer les fichiers concernés, examiner la logique de vérification des tokens et proposer une piste de correction.
Dans un workflow plus avancé, vous pouvez également autoriser l’agent à modifier le code sur une branche dédiée, puis relancer automatiquement les tests.
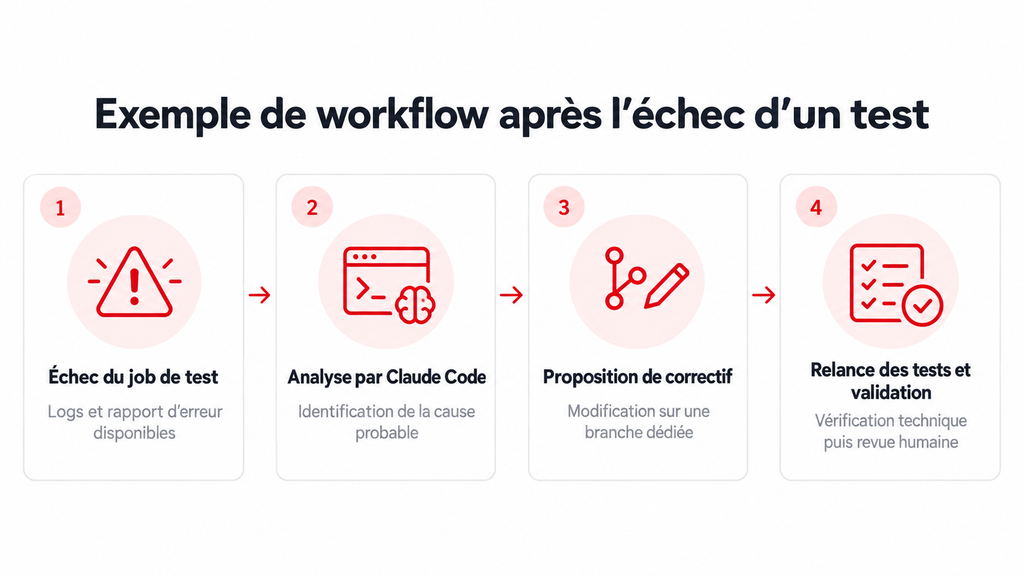
Attention à ne pas créer une boucle infinie de corrections ! Il est préférable de limiter le nombre de tentatives et d’arrêter le workflow si les tests continuent d’échouer.
Résultat attendu : une analyse documentée de l’échec, éventuellement accompagnée d’une proposition de correction testée, sans fusion automatique dans la branche principale.
3. Générer des tests et mettre à jour la documentation technique
La rédaction des tests et la mise à jour de la documentation font partie de ces tâches qu’on repousse facilement lorsqu’on manque de temps. Pourtant, elles sont indispensables pour maintenir un projet dans de bonnes conditions.
Avec Claude Code, vous pouvez déclencher automatiquement la génération de tests ou de documentation à partir des modifications apportées au repository.
Prenons une nouvelle fonctionnalité de gestion des utilisateurs. Après un commit, Claude Code peut examiner les changements et proposer des tests unitaires couvrant les nouveaux comportements, les cas limites ou la gestion des erreurs.
Voici un exemple de prompt :
Analyse les modifications apportées au module de gestion des utilisateurs.
Identifie les nouveaux comportements qui nécessitent des tests unitaires.
Génère les tests correspondants en respectant :
- Le framework de test existant
- Les conventions définies dans CLAUDE.md
- La structure actuelle du projet
Ne modifie pas le code de production.
Le même principe s’applique à la documentation. Lorsqu’une API évolue, l’agent peut analyser les nouvelles routes, les paramètres ou les changements de comportement et proposer une mise à jour du README ou de la documentation technique. Pour les environnements de test qui simulent une API, voir aussi notre article sur JSON Server.
Ces deux automatisations peuvent être séparées dans des jobs distincts pour faciliter leur suivi.
Je recommande toutefois de soumettre les fichiers générés à une pull request plutôt que de les intégrer directement. Un test produit par une IA n’est pas nécessairement pertinent, et une documentation générée doit toujours correspondre au comportement réel de l’application.
Résultat attendu : des fichiers de tests ou de documentation proposés automatiquement, puis vérifiés par les contrôles du pipeline et les développeurs.
4. Transformer une issue GitHub ou GitLab en pull request
C’est un cas d’usage plus avancé, mais particulièrement intéressant pour réduire le temps consacré aux petites tâches de développement.
Le principe est simple : à partir d’une issue suffisamment détaillée, Claude Code peut analyser le besoin, explorer le repository et préparer une proposition d’implémentation.
Imaginons cette issue GitHub :
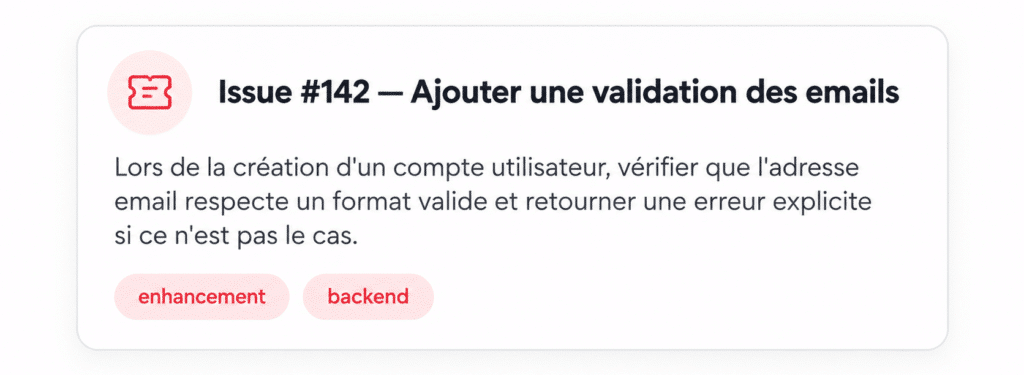
Une fois le workflow déclenché, Claude Code peut explorer le module d’inscription, identifier les fichiers concernés, proposer une modification et ajouter les tests correspondants.
Avec une intégration disposant des permissions nécessaires, il est ensuite possible de créer une branche, d’y enregistrer les changements et d’ouvrir automatiquement une pull request contenant la proposition d’implémentation.
Sur GitHub, ce type de workflow peut notamment être déclenché à partir d’une mention @claude dans une issue, lorsque l’intégration est configurée pour y répondre.
Bien sûr, cela ne signifie pas que toutes les issues peuvent être transformées en code sans supervision. Pour fonctionner correctement, le besoin doit être suffisamment précis et le périmètre de modification bien défini.
Je réserverais donc cette automatisation, dans un premier temps, aux corrections simples, aux petites évolutions fonctionnelles et aux tâches techniques bien documentées.
Résultat attendu : une pull request ou merge request contenant une proposition d’implémentation, des tests associés et un résumé des modifications, prête à être examinée par un développeur.
Ces quatre exemples montrent bien l’intérêt de Claude Code dans un pipeline CI/CD : automatiser non seulement l’exécution, mais aussi une partie de l’analyse et de la préparation du travail de développement.
Mais plus on donne de responsabilités à un agent, plus il devient important de contrôler ce qu’il peut faire. Permissions, accès aux secrets, consommation de tokens, gestion des échecs… Ce sont ces garde-fous qui font la différence entre une démonstration intéressante et un workflow fiable en production.
Sécuriser et fiabiliser ses pipelines Claude Code
Faire tourner Claude Code automatiquement dans un pipeline CI/CD, c’est pratique. Mais contrairement à une session interactive, personne n’est là pour valider chaque action de l’agent en temps réel. Il faut donc anticiper ce qu’il peut faire, les ressources auxquelles il accède et la manière dont le pipeline réagit en cas de problème.
L’objectif n’est pas de multiplier les contraintes, mais de rendre les automatisations suffisamment fiables pour être utilisées au quotidien. Et pour ça, quelques bonnes pratiques font toute la différence.
Commencez par limiter les permissions de Claude Code au strict nécessaire. Un agent chargé d’analyser une pull request n’a pas besoin de modifier le code, de supprimer des fichiers ou de déclencher un déploiement. Vous pouvez encadrer ses actions grâce aux paramètres de permissions et aux règles définies dans la configuration du projet.
Par exemple, pour demander une analyse sans autoriser les modifications du code source :
claude -p \
 "Analyse les problèmes potentiels de sécurité dans ce projet." \
 --tools "Read,Grep,Glob" --permission-mode dontAsk \
 --max-turns 5
Avec –tools, Claude Code n’a accès qu’aux outils de lecture, et –permission-mode dontAsk refuse toute action qui aurait nécessité une confirmation. Le mode plan, souvent cité, est avant tout conçu pour l’usage interactif : son comportement en mode headless n’est pas documenté, mieux vaut ne pas s’y fier comme garantie de lecture seule. Pour les exécutions automatisées, évitez également –dangerously-skip-permissions (alias de –permission-mode bypassPermissions), sauf dans un environnement isolé et spécifiquement prévu à cet effet.
Autre point essentiel : ne stockez jamais vos clés API et autres identifiants directement dans vos fichiers YAML. Utilisez les GitHub Secrets ou les variables protégées de GitLab CI/CD pour transmettre les credentials nécessaires au job, sans les écrire en clair dans le repository.
Sur des infrastructures AWS ou Google Cloud, l’authentification peut aussi reposer sur OIDC et la fédération d’identité (Workload Identity Federation), afin d’obtenir des credentials temporaires plutôt que de conserver des clés permanentes.
Attention également aux contenus que Claude Code analyse. Une issue, un commentaire de pull request, une ressource exposée par un serveur MCP ou un fichier du repository peut contenir des instructions malveillantes. C’est le principe de l’injection de prompt : tenter de détourner le comportement de l’agent à partir de données qu’il consulte. Il faut donc considérer ces contenus comme non fiables et limiter les outils, les accès réseau et les ressources disponibles dans le job.
Dans le même esprit, sachez qu’en mode -p sans –bare, Claude Code exécute les hooks et charge les serveurs MCP déclarés dans le repository (.claude/settings.json, .mcp.json) sans la confirmation de confiance affichée en mode interactif. Un dépôt forké ou une PR externe peut donc embarquer une configuration malveillante. Sur des pipelines exposés à des contributions externes, préférez –bare ou –strict-mcp-config avec une configuration MCP fournie par le job.
Gérer les erreurs sans bloquer inutilement le pipeline
Une exécution Claude Code peut échouer pour différentes raisons : clé API invalide, limite d’utilisation atteinte, problème réseau, permission manquante ou timeout. Et contrairement à un usage interactif, personne ne peut intervenir immédiatement pour débloquer la situation.
Je vous recommande donc de prévoir des mécanismes de gestion des erreurs dès la configuration du workflow.
Le plus important est de distinguer trois situations : une analyse qui s’est terminée sans détecter de problème, une analyse qui a identifié des anomalies et une analyse qui n’a pas pu aboutir.
Ces trois résultats ne doivent surtout pas être interprétés de la même manière. Une revue de code qui échoue ne signifie pas que le code est valide ! Concrètement, deux vérifications suffisent dans le job : le code de sortie de claude (0 en cas de succès, non nul en cas d’échec ou de limite –max-turns atteinte) et le contenu du JSON retourné. Par exemple :
claude -p "..." --output-format json > claude-review.json || { echo "Exécution Claude Code échouée"; exit 1; }
jq -e '.structured_output.issues | length == 0' claude-review.json \
  && echo "Aucune anomalie" \
  || echo "Anomalies détectées, voir claude-review.json"
Pour éviter les exécutions interminables, vous pouvez notamment limiter le nombre de tours de l’agent avec –max-turns et prévoir un timeout au niveau du job CI/CD.
Les retries peuvent être utiles pour les erreurs temporaires, comme une indisponibilité de l’API. En revanche, relancer automatiquement une exécution qui échoue à cause d’un problème de permissions ou de configuration ne résoudra rien.
Maîtriser les coûts et les performances
Chaque exécution de Claude Code consomme des ressources, notamment des tokens via l’API Anthropic ou un fournisseur de modèles utilisé. Et lorsqu’un workflow est déclenché à chaque commit ou pull request, les coûts peuvent rapidement s’accumuler.
Le bon réflexe consiste à réserver l’exécution de Claude Code aux événements qui présentent un réel intérêt.
Par exemple, inutile de déclencher une analyse complète du repository à chaque modification d’un fichier de documentation. Vous pouvez utiliser les filtres GitHub Actions ou les règles GitLab CI/CD (rules) pour cibler certains fichiers, branches ou événements.
Il est également possible de définir un budget maximal par exécution :
claude -p \
 "Analyse les modifications et identifie les bugs potentiels." \
 --max-turns 5 \
 --max-budget-usd 0.50 \
 --output-format json
Cette commande limite le nombre de tours de l’agent et fixe un plafond de dépenses de 0,50 dollar pour l’exécution. Ce plafond repose sur une estimation côté client du coût consommé (sous-agents inclus), pas sur une limite appliquée par l’API : c’est un garde-fou, pas une garantie absolue. Le montant est ici purement illustratif : le budget pertinent dépend de la complexité de vos analyses.
Je conseille également de suivre quelques indicateurs simples : durée moyenne d’exécution, coût par job, consommation de tokens, taux d’erreur et fréquence des interventions humaines.
Vous pouvez ainsi identifier les workflows qui apportent réellement de la valeur et ceux dont le coût ou la complexité ne justifie pas l’automatisation.
Les bonnes pratiques à retenir
| Point de vigilance | Bonne pratique |
| Permissions | Limiter les outils et les actions autorisés à chaque job |
| Clés API et secrets | Utiliser GitHub Secrets, GitLab CI/CD Variables ou une identité fédérée |
| Injection de prompt | Isoler les exécutions et considérer les contenus externes comme non fiables |
| Erreurs d’exécution | Vérifier les codes de sortie et distinguer les échecs des analyses sans anomalie |
| Timeouts et retries | Définir des limites et relancer uniquement les erreurs temporaires |
| Coûts API | Cibler les déclencheurs, limiter les tours et surveiller les tokens consommés |
| Qualité du code | Maintenir les tests automatisés et les contrôles déterministes |
| Déploiements | Conserver une validation humaine pour les modifications et opérations sensibles |
Enfin, gardez en tête que Claude Code reste un agent IA : ses résultats doivent être vérifiés. Une correction proposée peut introduire une régression, une analyse de sécurité peut manquer une vulnérabilité et un test généré peut ne pas couvrir le bon comportement.
C’est pourquoi je recommande de conserver les protections de branches, les revues humaines et les validations avant déploiement, même lorsque plusieurs étapes du workflow sont automatisées.
Une fois ces garde-fous en place, vous disposez d’une base solide pour faire évoluer vos usages. La prochaine étape consiste à passer de quelques pipelines expérimentaux à une utilisation standardisée de Claude Code à l’échelle de vos équipes de développement.
Industrialiser Claude Code dans les workflows DevOps de l’entreprise
Automatiser la revue d’une pull request ou l’analyse d’un test échoué, c’est une première étape. Mais lorsque plusieurs équipes commencent à utiliser Claude Code dans leurs pipelines CI/CD, un nouveau défi apparaît : comment éviter que chaque projet développe ses propres configurations, prompts et règles de sécurité ?
Parce qu’on connaît le problème : un workflow GitHub Actions fonctionne parfaitement sur un repository, un autre utilise une configuration différente sur GitLab, et six mois plus tard, plus personne ne sait vraiment pourquoi certaines permissions ont été accordées.
Pour passer à l’échelle, l’enjeu est de standardiser les usages de Claude Code sans perdre la souplesse nécessaire à chaque projet.
Standardiser les configurations avec CLAUDE.md et les Skills
L’un des premiers leviers consiste à centraliser les instructions communes dans un fichier CLAUDE.md. Ce fichier permet de donner à Claude Code les informations dont il a besoin pour travailler dans le contexte du projet : architecture applicative, conventions de développement, commandes de test ou règles de qualité.
Plutôt que de répéter ces informations dans chaque prompt CI/CD, vous pouvez les maintenir directement dans votre repository Git, comme n’importe quel autre fichier versionné.
Les Skills Claude Code permettent d’aller plus loin en définissant des procédures réutilisables pour certaines tâches. Vous pouvez, par exemple, créer une Skill dédiée à la revue de code, avec des critères d’analyse communs à plusieurs équipes, ou une autre consacrée à la génération de tests.
Pour les consignes propres à un job (critères d’une revue de sécurité, format de sortie attendu), –append-system-prompt ou –append-system-prompt-file permettent de les injecter au niveau système sans les répéter dans chaque prompt, et sans écraser les instructions par défaut de Claude Code.
L’idée est de construire progressivement un référentiel partagé, tout en laissant chaque projet préciser ses propres contraintes.
Voici un exemple d’organisation :
mon-projet/
├── CLAUDE.md
├── .claude/
│   └── skills/
│       ├── code-review/
│       │   └── SKILL.md
│       └── generate-tests/
│           └── SKILL.md
├── .github/
│   └── workflows/
│       ├── claude-review.yml
│       └── claude-tests.yml
├── src/
└── tests/
Cette structure permet de séparer les instructions du projet, les compétences de l’agent et les mécanismes d’exécution des jobs du pipeline.
Attention toutefois : pour que Claude Code exploite ces fichiers, ils doivent être accessibles dans l’environnement du job. Comme nous l’avons vu plus haut, certaines options d’exécution, comme –bare, désactivent leur chargement automatique.
Mesurer l’efficacité des workflows automatisés
Une fois les premières automatisations en place, je vous conseille de ne pas vous arrêter au simple constat que « le pipeline fonctionne ».
La vraie question, c’est ce que Claude Code apporte à vos équipes de développement.
Une revue de code automatisée qui génère beaucoup de commentaires, mais dont aucun n’est pertinent, n’apporte pas nécessairement de valeur. À l’inverse, une automatisation qui identifie régulièrement des erreurs avant leur intégration peut faire gagner un temps précieux.
Pour évaluer l’efficacité de vos workflows, quelques indicateurs suffisent pour commencer :
| Indicateur | Ce qu’il permet de mesurer |
| Temps moyen de revue des PR/MR | L’évolution du délai de traitement des modifications |
| Taux de recommandations acceptées | La pertinence des analyses de Claude Code |
| Taux de réussite des jobs IA | La fiabilité des exécutions automatisées |
| Temps consacré aux corrections | L’efficacité des workflows d’analyse et de résolution des erreurs |
| Coût moyen par exécution | Le rapport entre les ressources consommées et la valeur produite |
| Nombre d’interventions humaines | Le niveau d’automatisation réellement atteint |
L’idéal est de comparer ces indicateurs avant et après l’intégration de Claude Code, puis d’ajuster progressivement les prompts, les permissions et les événements déclencheurs.
Inutile de chercher à tout automatiser dès le départ. Mieux vaut quelques workflows fiables, bien maîtrisés et réellement utilisés par les développeurs qu’une multiplication d’agents difficiles à maintenir.
Conclusion : Claude Code en CI/CD, de l’automatisation à l’industrialisation
Intégrer Claude Code dans ses pipelines CI/CD est aujourd’hui accessible grâce au mode headless et aux intégrations GitHub Actions et GitLab CI/CD. Mais faire fonctionner un agent IA dans un pipeline et l’utiliser efficacement à l’échelle d’une entreprise, ce sont deux choses différentes.
Pour aller plus loin, encore faut-il que les fondations techniques suivent : un code maintenable, des tests automatisés fiables, des environnements reproductibles, une politique de sécurité et des règles d’accès adaptées. C’est tout l’enjeu d’une Stack AI-Ready, capable d’accueillir les agents IA dans les processus de développement sans compromettre la qualité du logiciel.
Chez Eleven Labs, agence Claude, c’est justement cette approche que nous privilégions pour accompagner les équipes dans l’industrialisation de Claude Code en entreprise. L’objectif n’est pas simplement d’ajouter de l’IA aux workflows existants, mais de créer les conditions pour qu’elle apporte une réelle valeur au quotidien.
Mon conseil ? Commencez par un cas d’usage simple, mesurez ce qu’il vous apporte, puis élargissez progressivement. L’important n’est pas d’automatiser le plus de tâches possible, mais de construire des workflows fiables, utiles et maîtrisés.
Prêts à intégrer Claude Code dans vos workflows de développement ?
Nos experts certifiés Claude vous accompagnent pour intégrer et automatiser vos workflows de développement avec Claude Code.