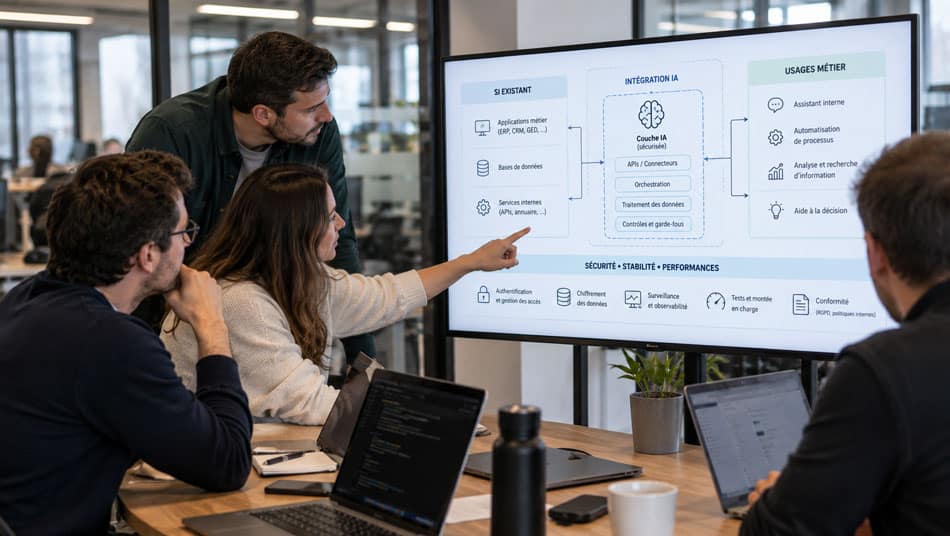
Un assistant IA connecté à votre documentation interne, un agent capable d’interagir avec votre ERP ou votre CRM, une automatisation intelligente de vos processus métier… Sur le papier, les possibilités sont séduisantes. Mais que se passe-t-il lorsque ces solutions rencontrent la réalité de votre système d’information existant ?
Des applications legacy, des données dispersées, des API parfois limitées, des infrastructures cloud ou historiques, des contraintes de cybersécurité et des règles de gouvernance déjà en place. Intégrer une IA dans cet environnement soulève bien plus de questions qu’un simple choix de modèle ou de technologie.
Car contrairement à une application classique, un agent IA peut analyser, décider et agir sur plusieurs systèmes à la fois. Une capacité précieuse pour les équipes métier, mais qui impose de repenser certains mécanismes de contrôle, de traçabilité, de confidentialité et de gestion des accès.
Alors, comment réussir cette intégration sans compromettre la sécurité, la qualité des données ou la stabilité du SI ? En tant qu’architecte SI chez Eleven Labs, je vous propose une approche concrète pour identifier les bons usages, anticiper les risques et préparer un déploiement maîtrisé, du cadrage jusqu’à la mise en production.
Identifier les bons cas d’usage de l’IA dans son système d’information
Avant de réfléchir à l’architecture technique ou au choix d’un modèle d’intelligence artificielle, il faut parler d’usage. Pourquoi souhaite-t-on intégrer de l’IA dans son SI ? Quels processus métier cherche-t-on à améliorer ? Et surtout, quelle valeur ajoutée cette nouvelle technologie apportera-t-elle par rapport aux solutions déjà en place ?
Pour une entreprise, l’objectif peut être de réduire le temps consacré à certaines tâches, d’améliorer la qualité d’un service ou de rendre l’information plus facilement accessible aux collaborateurs. Dans un système d’information, j’observe trois grandes familles de cas d’usage où l’IA apporte une valeur réelle.
La recherche documentaire. Dans un SI de taille conséquente, l’information est presque toujours distribuée : wiki, GED, tickets, référentiels, documentation projet ou bases de connaissances. Une IA capable d’interroger ces sources et de restituer une réponse pertinente peut faire gagner un temps considérable aux utilisateurs. Une architecture RAG (Retrieval-Augmented Generation) peut notamment permettre d’enrichir les réponses d’un modèle de langage à partir de documents internes, sans nécessiter son réentraînement.
L’assistance au quotidien. Un assistant IA interne peut guider les collaborateurs dans leurs procédures, leurs outils ou leurs questions RH et IT. Les chatbots existaient déjà il y a dix ans, mais ils suivaient essentiellement un parcours codé à l’avance. L’IA générative permet aujourd’hui des interactions beaucoup plus souples, fondées sur la compréhension du langage naturel.
La classification et le traitement de documents. Trier, qualifier, extraire de l’information de documents hétérogènes, comme des factures, des commandes ou des demandes entrantes : ce sont des tâches longues pour un humain, qui peuvent être confiées à l’IA à condition d’être bien cadrées et évaluées. L’enjeu est notamment d’automatiser certaines opérations tout en conservant une validation humaine lorsque le risque métier le justifie.
Le point commun de ces usages, c’est l’ambiguïté. On ne sait pas toujours exactement où se trouve l’information, comment l’interpréter ou quelle démarche suivre pour répondre à une demande. C’est précisément là que l’IA prend sa valeur. À l’inverse, nos systèmes existants reposent largement sur des algorithmes déterministes, et c’est une qualité. Un processus répétitif, au parcours prévisible et aux règles connues, est très bien servi par un script, un workflow ou un développement logiciel classique : fiable, testable, à coût maîtrisé. Automatiser, c’était déjà notre métier bien avant l’IA.
| Nature de la tâche | Exemple | Réponse la plus adaptée |
| Répétitive et déterministe | Synchroniser deux référentiels, appliquer une règle de gestion | Script, workflow ou développement classique |
| Ambiguë, avec une information dispersée | Retrouver une procédure dans plusieurs sources, qualifier une demande client | IA ou agent IA avec évaluation et garde-fous |
| Ponctuelle | Réaliser une transformation de données une ou deux fois | Assistant IA utilisé directement, sans industrialisation |
Il faut également distinguer l’utilisation d’un modèle IA dans un processus de celle d’un agent autonome. Une IA peut être appelée ponctuellement pour analyser un document ou produire une réponse. Un workflow peut combiner des traitements classiques et plusieurs appels à un modèle. Un agent IA va plus loin : il peut sélectionner des outils, solliciter différentes fonctionnalités et adapter ses actions aux informations recueillies.
Ma première règle d’architecte : mettre de l’IA à chaque étape d’un système d’information est rarement nécessaire. Il existe de nombreux cas d’usage où elle apporte une vraie valeur ajoutée, qu’il s’agisse d’un gain de temps, d’une amélioration de l’expérience utilisateur ou d’une réduction des tâches manuelles. Encore faut-il identifier ces bénéfices et les mesurer avant de concevoir quoi que ce soit. C’est tout l’enjeu du cadrage d’un projet IA et de l’évaluation de son retour sur investissement (ROI).
Cartographier le SI pour anticiper les impacts de l’intégration de l’IA
Une fois le cas d’usage identifié, il faut comprendre comment la solution IA va s’intégrer dans l’architecture existante. Un modèle, un assistant ou un agent IA ne fonctionne pas nécessairement de manière isolée. Il peut être amené à consulter des données, interroger des applications métier, déclencher des traitements ou alimenter d’autres systèmes. La question devient alors : où placer cette nouvelle brique dans le système d’information, et quelles conséquences son intégration aura-t-elle sur l’existant ?
C’est là que la cartographie du système d’information redevient un outil central. Sans vision claire des applications, des flux et des données, difficile de mesurer ce que l’IA va toucher. Avec une cartographie à jour, on peut positionner cette nouvelle capacité comme n’importe quelle autre brique du SI et en déduire ses impacts. Un diagnostic de l’architecture existante permet notamment de mieux comprendre les dépendances entre les logiciels métier, les bases de données, les services cloud et les applications historiques, parfois qualifiées de legacy.
Pour chaque projet d’intégration IA, je me pose systématiquement les questions suivantes.
| Question d’architecte | Ce qu’elle permet d’anticiper |
| À quel moment du processus l’IA intervient-elle ? | Son rôle métier, ses déclencheurs, ce qu’elle remplace ou complète |
| Quelles données consomme-t-elle ? | Les sources à exposer, leur qualité et leur sensibilité |
| Quelles données produit-elle ou distribue-t-elle ? | Les applications en aval, les référentiels alimentés et les risques de propagation d’erreurs |
| Quelles connexions faut-il mettre en place ? | Les API à créer ou à ouvrir, les éventuels serveurs MCP, les connecteurs et l’infrastructure associée |
| Quelles applications existantes sont impactées ? | Les évolutions à prévoir dans le SI, y compris sur la plateforme data ou le data lake |
Prenons l’exemple d’un assistant IA connecté à plusieurs sources documentaires internes. Il faut déterminer où se trouvent les informations, comment elles sont accessibles, mais aussi si l’assistant doit uniquement les consulter ou effectuer des actions dans les applications concernées. Ces choix vont directement influencer l’architecture d’intégration et les composants techniques nécessaires à sa mise en œuvre.
C’est sans doute l’un des aspects les plus souvent sous-estimés. Lorsqu’on décide d’intégrer une IA, toutes les applications avec lesquelles elle interagit sont potentiellement impactées. Il peut être nécessaire de créer de nouveaux flux, d’exposer des API REST, de développer un connecteur sur mesure, de revoir certaines règles d’habilitation ou de faire évoluer les modèles de données.
Ces modifications peuvent également concerner la plateforme data, les référentiels ou les mécanismes d’échange entre applications. Dans certaines architectures, une couche middleware assure déjà une partie de ces échanges et devra elle aussi être prise en compte. C’est particulièrement vrai dans les organisations disposant de plusieurs générations de logiciels, où les applications historiques cohabitent avec des services cloud et de nouveaux outils numériques.
Le coût d’un projet IA ne se limite donc pas au développement de la solution elle-même. Il comprend aussi toutes les adaptations nécessaires sur le système d’information existant. Ce travail doit être identifié et estimé dès le cadrage, qu’il s’agisse d’une PME, d’une ETI ou d’une grande entreprise.
Choisir comment connecter l’IA aux applications existantes
Une fois les dépendances identifiées, il faut définir comment l’IA va communiquer avec les applications et accéder aux informations dont elle a besoin. Il n’existe pas une architecture d’intégration unique. Les choix dépendent des systèmes en place, de la nature du projet, des contraintes d’infrastructure et du niveau d’autonomie attendu. L’enjeu est de connecter l’intelligence artificielle aux outils métier sans fragiliser les applications existantes, tout en conservant des mécanismes de contrôle adaptés.
Les API pour connecter l’IA aux outils métier
Les API constituent un moyen de connecter une solution IA aux applications existantes. Elles permettent d’exposer certaines données ou fonctionnalités sans donner nécessairement au modèle un accès direct aux systèmes sous-jacents. Par exemple, un assistant IA destiné au support interne peut avoir besoin de consulter les informations d’un outil de ticketing. Une API permet de lui transmettre les données nécessaires et, si le besoin le justifie, d’exposer certaines opérations métier.
Le même principe peut s’appliquer à un ERP, un CRM comme Salesforce ou à une application métier développée sur mesure. Une API peut permettre de consulter une fiche client, de récupérer une information de commande ou de transmettre une demande à un service existant. L’intégration repose alors sur des interfaces dont le comportement est défini et contrôlé.
Dans certains cas, les API sont déjà disponibles. Dans d’autres, il faut les créer, les adapter ou revoir les mécanismes d’authentification existants. Cela peut nécessiter un développement spécifique ou la mise en place de nouveaux connecteurs.
Le Model Context Protocol (MCP) pour connecter les agents IA au SI
Lorsque l’on souhaite intégrer des agents IA capables d’utiliser plusieurs outils, le Model Context Protocol (MCP) mérite une attention particulière. Ce protocole standardise la manière dont une application IA accède à des outils et à des données. Pour l’architecte SI, chaque serveur MCP constitue une nouvelle porte d’entrée vers le système d’information. Il permet de rendre certaines fonctionnalités accessibles aux agents, éventuellement en s’appuyant sur les API existantes.
Mais il ne faut pas considérer cette interface comme un simple connecteur technique. Un serveur MCP se conçoit, se sécurise, se supervise et se maintient comme une API. Il faut déterminer quelles opérations il expose, qui peut les utiliser et dans quelles conditions. Il introduit aussi des risques qui n’existent pas sur une API classique : un serveur tiers non audité, des descriptions d’outils contenant des instructions cachées (tool poisoning), ou la combinaison d’un outil de lecture de données sensibles avec un outil d’écriture vers l’extérieur, qui ouvre une voie d’exfiltration. D’où le principe du moindre privilège, appliqué outil par outil. Cette nouvelle couche d’intégration doit donc trouver sa place dans la cartographie et dans les règles de gouvernance du SI.
Adapter l’architecture au niveau d’autonomie attendu
Toutes les intégrations IA n’ont pas besoin d’une architecture agentique. Pour un traitement documentaire, un pipeline classique qui appelle un modèle IA à une étape précise peut suffire. Par exemple, la classification automatique de documents peut être intégrée dans un processus existant sans nécessiter le déploiement d’un agent autonome.
Pour une automatisation métier dont les étapes sont connues, un workflow peut être plus approprié. En revanche, lorsqu’une solution doit choisir entre plusieurs outils, interroger différentes sources et adapter son parcours en fonction des réponses obtenues, une architecture agentique peut apporter davantage de flexibilité.
Le type de modèle utilisé compte également. Selon le besoin, on peut faire appel à un modèle de langage naturel, à des techniques de machine learning ou à une solution spécialisée dans l’analyse de documents et la vision par ordinateur. Ces approches ne répondent pas nécessairement aux mêmes objectifs et n’impliquent pas les mêmes contraintes d’intégration. L’objectif reste de choisir une architecture proportionnée à la complexité réelle du besoin, sans multiplier inutilement les composants, les appels aux modèles et les interactions entre services.
Sécuriser l’intégration de l’IA dans le système d’information
Quand on me demande par où commencer sur les questions d’architecture agentique, ma réponse est toujours la même : la sécurité. L’intégration d’une IA dans le SI introduit de nouveaux flux de données et potentiellement de nouveaux accès aux applications. Avec les agents IA, cette question prend une dimension particulière, puisqu’ils peuvent être capables de consulter, croiser, produire et transmettre des informations, voire d’exécuter certaines actions. Ces nouvelles capacités doivent s’inscrire dans la politique de cybersécurité et de gouvernance de l’entreprise, au même titre que les autres services du système d’information.
C’est un changement important par rapport aux briques classiques. Une base de données à laquelle on donne un accès large reste passive : elle n’ira pas d’elle-même écrire sur Internet, consulter d’autres sources ou exploiter les données qu’elle contient. Un agent IA, lui, peut le faire lorsqu’il dispose des outils et des autorisations nécessaires. C’est ce qui fait sa valeur, mais aussi ce qui impose un cadre strict.
Un agent IA interne doit être considéré comme une nouvelle identité dans le système d’information, avec ses droits d’accès, ses responsabilités et ses restrictions. Le principe que j’applique est simple : ce qu’un collaborateur n’a pas le droit de faire dans le SI, l’agent qui l’assiste n’a pas le droit de le faire non plus. Sinon, l’architecture devient incohérente et l’agent risque de contourner les règles d’habilitation existantes.
Concrètement, cela implique de définir pour chaque agent les applications et les sources auxquelles il peut accéder, les opérations autorisées en lecture ou en écriture, ainsi que l’identité sous laquelle il agit. Il peut s’agir d’un compte technique dédié ou des droits de l’utilisateur qu’il assiste. Il faut également comprendre ce que l’agent fait des informations qu’il manipule : où elles sont stockées, à qui elles sont transmises, quel modèle les traite et dans quel environnement. Pour certaines opérations sensibles, comme la modification d’une donnée client ou la validation d’une commande, un contrôle supplémentaire ou une validation humaine peut être nécessaire.
Deux réflexes complètent ce cadre. Le premier consiste à protéger les informations personnelles et sensibles avant de les transmettre au modèle. Selon le besoin, cela peut passer par des mécanismes d’anonymisation, de masquage ou de filtrage. Cette protection participe notamment à la mise en conformité avec le RGPD lorsque le traitement concerne des données personnelles. Il faut également vérifier la finalité du traitement, les conditions de conservation et les responsabilités des différents acteurs.
Le règlement européen sur l’IA (AI Act) s’ajoute désormais au RGPD. Depuis le 2 août 2026, les obligations de transparence de l’article 50 s’appliquent : un utilisateur qui échange avec un assistant IA doit en être informé clairement, et les contenus générés doivent pouvoir être identifiés comme tels. L’obligation de formation des équipes à l’IA (article 4) est, elle, en vigueur depuis février 2025. Les obligations les plus lourdes, réservées aux systèmes dits à haut risque (recrutement, notation de crédit, éducation, biométrie), ont été reportées par le Digital Omnibus au 2 décembre 2027 pour les systèmes autonomes et au 2 août 2028 pour ceux intégrés à des produits déjà réglementés. Dès le cadrage, il faut donc qualifier le cas d’usage au regard de cette classification : un tri automatique de candidatures n’a pas le même statut réglementaire qu’une recherche documentaire interne.
Le second réflexe est de tester la résistance de la solution aux injections de prompt. Ces attaques consistent notamment à introduire des instructions malveillantes dans les contenus traités afin de détourner le comportement du modèle ou de l’agent. Des outils d’évaluation, des tests de sécurité et des exercices de red teaming permettent d’identifier certaines vulnérabilités avant la mise en production.
La gouvernance des données compte également : savoir dans quelle juridiction elles sont traitées fait partie des décisions d’architecture. Cette question doit être examinée lors du choix d’un fournisseur cloud, d’une API ou d’un service IA externe. Les options existent : régions européennes des hyperscalers, fournisseurs de modèles hébergés en Europe, ou déploiement de modèles ouverts sur sa propre infrastructure lorsque la confidentialité l’impose. Ces sujets sont particulièrement importants lorsque l’IA accède à des informations confidentielles ou intervient dans des processus métier sensibles, notamment dans des domaines comme la finance ou la santé.
Préparer les données existantes pour garantir la fiabilité de l’IA
Un agent IA ne vaut que par les données qu’on lui confie. La règle est simple : des données difficiles à exploiter pour un humain seront tout aussi difficiles à exploiter pour une IA. La recherche documentaire en est l’illustration parfaite. Imaginons une solution IA connectée à plusieurs sources d’information, comme c’est souvent le cas dans un système d’information d’entreprise. Si l’une de ces sources n’est plus à jour ou si deux référentiels se contredisent, la solution risque de produire des réponses incohérentes. Et la confiance des utilisateurs peut se dégrader très rapidement.
C’est notamment un point de vigilance dans une architecture RAG, où la qualité des documents retrouvés et transmis au modèle influence directement la pertinence de ses réponses. Avant de connecter une IA à des sources existantes, je recommande de vérifier trois points.
- La fraîcheur : les sources sont-elles maintenues à jour ? Qui est responsable de leur actualisation ? Une base documentaire obsolète peut rapidement devenir problématique, même avec un modèle performant.
- La cohérence : existe-t-il une source de référence lorsque plusieurs informations divergent ? Cette question est essentielle lorsque les données sont réparties entre différents logiciels métier, ERP, CRM ou référentiels internes.
- La pertinence : chaque document ou donnée accessible apporte-t-il une réelle valeur à la solution ? Les informations transmises doivent correspondre au besoin de l’utilisateur et au périmètre du cas d’usage.
Ce dernier point est souvent contre-intuitif. On a tendance à penser qu’un agent ayant accès à toutes les informations de l’entreprise sera nécessairement plus performant. En réalité, un contexte trop volumineux et hétérogène peut dégrader la qualité des réponses. Les informations pertinentes risquent de se retrouver noyées parmi des contenus inutiles, redondants ou contradictoires. Sélectionner les bonnes sources fait donc pleinement partie du travail d’architecture.
Faut-il revoir son architecture data avant d’intégrer l’IA ? Pas nécessairement dans son ensemble. Mais un projet IA peut rapidement mettre en évidence des difficultés préexistantes : données dispersées, référentiels redondants, documentation obsolète ou dépendances applicatives mal identifiées. Une phase de diagnostic peut alors permettre de déterminer si les données existantes sont réellement exploitables et quelles actions de préparation sont nécessaires.
C’est là que les démarches de rationalisation du portefeuille applicatif et la construction d’une roadmap d’architecture data prennent tout leur sens. Un SI lisible, des sources identifiées et des données maîtrisées constituent un terrain bien plus favorable à l’intégration de l’intelligence artificielle. Il n’est donc pas toujours nécessaire de lancer une transformation complète de son infrastructure data avant un projet IA. En revanche, les prérequis en matière de qualité, de gouvernance et d’accès aux données doivent être identifiés dès le départ.
Mettre en place l’observabilité et l’évaluation de l’IA
Sur un outil CRM stratégique, on veut savoir quel utilisateur a effectué quelle action et à quel moment. Pour un agent IA, c’est exactement pareil. On doit pouvoir remonter dans les logs, comprendre ce qui s’est passé et identifier les éléments qui ont conduit à un résultat donné. Cette exigence devient d’autant plus importante qu’un agent peut réaliser plusieurs opérations successives, utiliser différents outils et adapter son comportement au contexte.
Pour moi, l’observabilité ne se rajoute pas en fin de projet : elle se conçoit avec l’architecture. Il faut pouvoir tracer ce que l’agent a reçu en entrée, les outils qu’il a appelés et ce qu’il a produit en sortie. Ces informations permettent de déboguer la solution, de l’auditer et d’identifier les améliorations nécessaires. Côté outillage, les conventions sémantiques OpenTelemetry pour l’IA générative s’imposent comme le standard pour tracer les appels aux modèles et aux outils, ce qui évite de dépendre d’un fournisseur d’observabilité en particulier. L’objectif est de disposer d’une visibilité suffisante sur son fonctionnement pour comprendre les comportements inattendus, faciliter la détection des anomalies et intervenir lorsqu’un problème survient.
Cette traçabilité contribue également à la maintenance et au contrôle du service dans la durée. Elle facilite l’analyse des incidents, le suivi des évolutions et la validation des corrections apportées. Au-delà des traces techniques, il faut aussi mesurer la performance réelle de la solution.
| Métrique | Ce qu’elle mesure | Pourquoi elle compte |
| Temps de réponse | La performance perçue par l’utilisateur | Un agent trop lent risque d’être abandonné |
| Qualité et précision des réponses | L’adéquation du résultat au besoin réel | C’est le cœur de la valeur métier |
| Points de déviation | Le moment où une conversation ou une exécution s’écarte du résultat attendu | Ils orientent l’ajustement des prompts, des outils et des sources |
| Taux de résolution | La part des demandes traitées avant une escalade humaine | Il permet de mesurer l’efficacité opérationnelle |
| Coût par exécution | Le coût des appels aux modèles et des traitements associés | Il aide à anticiper le passage à l’échelle |
Sur un agent de support client, par exemple, le taux de résolution avant escalade permet de vérifier que la solution est correctement calibrée : elle traite ce qui doit l’être et transmet à un humain les situations qui le nécessitent. Ces indicateurs permettent aussi d’évaluer les gains réellement obtenus : réduction du temps de traitement, amélioration de la qualité des réponses ou diminution des interventions manuelles.
Un point de vigilance important : les traces d’observabilité peuvent contenir les informations transmises à l’agent. Si un utilisateur partage des données personnelles au cours d’un échange, elles risquent de se retrouver dans les logs si aucun mécanisme de protection n’a été prévu. La politique d’anonymisation et de protection des informations doit donc couvrir également les outils d’observabilité. Il faut notamment définir les données qui peuvent être conservées, leur durée de rétention et les permissions nécessaires pour y accéder. C’est un sujet à anticiper dès la conception, et non après l’apparition d’un problème.
Anticiper le coût complet de l’intégration de l’IA
Quand on parle du coût de l’intelligence artificielle, on pense d’abord au prix des abonnements ou à la consommation de tokens. Pour un architecte SI, ce n’est qu’une ligne de la facture. Tout ce qui entoure la solution IA a également un impact sur le système d’information, et donc sur le budget du projet.
| Poste de coût | Ce qu’il recouvre |
| Consommation du modèle | Tokens facturés via l’API, à l’usage |
| Évaluation | Conception et maintenance des tests, y compris les évaluations utilisant un LLM juge |
| Observabilité | Outillage de traçage, stockage et conservation des traces |
| Sécurité | Anonymisation, tests d’injection de prompt et red teaming |
| Intégration | API, connecteurs, serveurs MCP, infrastructure et évolutions des applications existantes |
| Évolution des modèles | Migrations liées aux nouvelles versions et à la dépréciation des anciennes |
Ces postes de dépenses doivent être pris en compte pour évaluer le coût total de possession de la solution, mais aussi son retour sur investissement. Il ne suffit pas de constater un gain de temps sur une tâche. Encore faut-il déterminer si ce gain compense les coûts de développement, de déploiement et de maintenance sur l’ensemble du cycle de vie du service.
Ces coûts ne sont pas une fatalité. Le cache de prompt pour les contextes répétés, le traitement par lot pour les tâches non urgentes et le routage vers un modèle plus petit lorsque la tâche le permet réduisent sensiblement la facture. Ces leviers se décident au moment de l’architecture, pas après coup.
Le piège du POC : sous-estimer les coûts d’industrialisation
Ces coûts sont rarement tous visibles au stade du POC. Ils apparaissent au moment d’industrialiser, lorsqu’il faut mettre en place les garde-fous, sécuriser les échanges, superviser la solution et garantir sa fiabilité. C’est souvent à ce moment-là que les projets ralentissent. Les anticiper dès le cadrage permet d’éviter de découvrir trop tard que l’architecture envisagée est difficile ou trop coûteuse à exploiter.
Ma recommandation : commencer petit. Un essai de quelques semaines sur un périmètre réduit, puis une mesure du coût réel, observabilité comprise, avant d’élargir progressivement. Cette approche permet de vérifier la valeur métier de la solution tout en confrontant les choix techniques à la réalité. Elle aide également à définir des objectifs mesurables avant d’engager un déploiement à plus grande échelle.
Comparer les modèles sur leur coût total, pas seulement sur les tokens
La phase d’expérimentation est aussi le bon moment pour comparer les modèles. Le prix au token peut être un indicateur trompeur. Un modèle moins cher à l’unité peut finalement coûter plus cher s’il multiplie les allers-retours pour atteindre le résultat attendu. Sur un projet interne d’analyse visuelle de documents, mes collègues ont ainsi constaté qu’Opus revenait moins cher que Sonnet, grâce à une consommation de tokens bien plus faible. Ce constat vaut pour ce cas précis et nos conditions d’utilisation : il ne se généralise pas, et c’est justement pourquoi la comparaison doit se faire sur vos propres cas d’usage.
C’est pourquoi je recommande de comparer les modèles sur des cas d’usage représentatifs, en prenant en compte la qualité du résultat, le nombre d’appels nécessaires et le coût global du traitement. Le choix d’un modèle ne doit donc pas uniquement reposer sur son tarif ou sur sa puissance de calcul, mais sur son efficacité réelle dans les conditions d’utilisation envisagées.
Prévoir les coûts dans la durée
Deux facteurs rendent ce coût mouvant. D’abord, les modèles évoluent et leurs anciennes versions sont progressivement dépréciées. Rester durablement sur une version ancienne est rarement possible, et chaque migration demande de réévaluer la solution. Ensuite, les conditions tarifaires des fournisseurs peuvent évoluer.
Un agent sollicité 10 000 fois par jour transforme la moindre variation de prix en enjeu budgétaire. C’est pourquoi j’intègre systématiquement cette trajectoire de coût dans la réflexion d’architecture. Cette anticipation est nécessaire pour construire une stratégie d’exploitation réaliste, notamment lorsque l’IA devient une composante essentielle d’un processus métier.
Passer du POC à une IA intégrée et exploitable en production
Réussir une première expérimentation ne signifie pas que la solution est prête à rejoindre durablement le système d’information. Un POC peut démontrer qu’un modèle est capable de répondre à une question, d’analyser des documents ou d’interagir avec une application. Mais le passage en production suppose de vérifier que cette capacité fonctionne dans les conditions réelles de l’entreprise.
La mise en œuvre d’une IA en production nécessite notamment de prendre en compte la sécurité, la maintenance, la gestion des erreurs et la capacité de la solution à évoluer avec les besoins métier. Je privilégie une démarche progressive. Il est préférable de commencer avec un cas d’usage clairement défini et un périmètre applicatif limité, plutôt que de connecter immédiatement une solution IA à plusieurs systèmes critiques.
Cette phase permet de vérifier les hypothèses de départ : qualité des données, performance des échanges, pertinence des réponses et fiabilité des accès. Elle permet aussi de mesurer les impacts réels sur les applications existantes. L’objectif est de valider non seulement le fonctionnement de l’IA, mais aussi sa capacité à s’insérer correctement dans l’architecture du SI. Les premiers retours des utilisateurs sont également précieux pour vérifier l’adéquation entre la solution développée et les besoins métier.
Une fois les premiers résultats validés, il faut s’assurer que la solution pourra être exploitée dans la durée. Cela implique notamment de disposer d’une architecture capable de gérer les erreurs, de superviser les traitements, de maintenir les connexions aux applications et de suivre la consommation des modèles. Les mécanismes d’évaluation doivent également permettre de contrôler le comportement de la solution lorsque les données, les modèles ou les usages évoluent.
Selon les processus concernés, des étapes de validation humaine peuvent être conservées pour les opérations présentant un risque important. Les équipes doivent aussi disposer des compétences et des procédures nécessaires pour assurer le suivi de la solution, traiter les incidents et accompagner son évolution. Industrialiser une IA ne consiste donc pas seulement à multiplier le nombre d’utilisateurs. Il faut construire les conditions de son exploitation : sécurité, fiabilité, observabilité, maintenance et maîtrise des coûts.
Vers une standardisation des architectures d’intégration IA ?
Aujourd’hui, chaque entreprise construit encore un peu son architecture agentique dans son coin, en fonction de son contexte technique et métier. C’est assez normal pour une technologie aussi jeune. Mais comme toute autre solution du monde informatique, l’IA agentique tend progressivement vers une standardisation.
Le signe le plus visible est le Model Context Protocol. Anthropic a conçu et publié ce protocole, qui a progressivement été adopté et intégré par de grands acteurs du marché. C’est souvent ainsi que les standards s’installent : un premier acteur propose un cadre, d’autres l’adoptent, puis les pratiques convergent.
Je vois un second signe dans les ressources de formation. Les différents fournisseurs tiennent un discours de plus en plus cohérent sur la manière de concevoir des architectures agentiques, les points de vigilance et les garde-fous nécessaires. Cette convergence contribue à structurer de nouvelles pratiques d’intégration, notamment autour de la sécurité des agents, de leur connexion aux applications métier et du contrôle de leurs actions.
J’ai passé la certification Claude Certified Architect – Foundations d’Anthropic. Ce qui m’a frappée, c’est son approche. Elle pousse vers une forme de standardisation par les bonnes pratiques et les avertissements : erreurs de conception à éviter, problèmes de sécurité et de coûts à anticiper, pièges dans la construction des agents, des workflows et des pipelines. Elle n’est d’ailleurs accessible qu’aux organisations membres du Claude Partner Network, ce qui en fait aussi un repère pour choisir un partenaire d’intégration.
Une approche plutôt bienveillante et assez agnostique : elle enseigne comment bâtir une stack agentique solide, bien au-delà de l’utilisation d’un modèle en particulier. Pour un architecte SI, c’est un bagage précieux. Cela donne un cadre commun pour dialoguer avec les équipes de développement, structurer les choix d’architecture et justifier les garde-fous auprès des directions métier.
C’est aussi pour cela que nous accompagnons nos experts dans cette certification chez Eleven Labs, et que nous avons rejoint le Claude Partner Network d’Anthropic en tant que Select Partner.
Les questions à se poser avant d’intégrer une IA dans son SI
Si je devais résumer cet article en une démarche, ce serait autour de quatre questions à poser avant toute conception.
- Quelle est la valeur ajoutée de l’IA dans ce processus ? Il faut identifier les processus candidats et mesurer ce que l’intelligence artificielle apporte réellement par rapport à un algorithme classique. L’amélioration de l’expérience utilisateur, le gain de temps ou la réduction de certaines tâches répétitives sont des réponses tout à fait valables, à condition de les expliciter et de pouvoir les évaluer.
- Nos données et notre système d’information permettent-ils cette intégration ? Il faut vérifier la fraîcheur, la cohérence et la pertinence des informations, mais aussi comprendre quelles applications et quels flux seront concernés. Un diagnostic de l’existant peut aider à identifier les prérequis techniques et les éventuelles adaptations nécessaires.
- Quel sera le coût complet, aujourd’hui et demain ? Consommation des modèles, évaluation, observabilité, sécurité, intégration, migrations : tous ces éléments doivent être considérés à l’échelle des volumes réels. Le retour sur investissement doit être apprécié au regard des coûts d’exploitation et des gains métier attendus.
- Quel impact sur l’architecture existante ? Applications voisines, flux, référentiels, plateforme data : une solution IA s’insère dans une cartographie et cette cartographie évolue avec elle. Il faut aussi anticiper les habilitations, les mécanismes de sécurité, les contraintes de conformité et les éventuelles validations humaines associées.
Il arrive que ces questions conduisent à conclure qu’un agent IA est superflu, trop coûteux ou surdimensionné pour le besoin. C’est un excellent résultat de cadrage : il permet d’éviter d’investir là où la valeur n’est pas.
Conclusion : intégrer l’IA dans son SI existant, une question d’architecture avant tout
L’intégration de l’intelligence artificielle ne remet pas en cause les fondamentaux de l’architecture du système d’information. Elle les rend plus exigeants. Sécurité et habilitations, cartographie, qualité des données, traçabilité, maîtrise des coûts : ce sont nos sujets de toujours, appliqués à une nouvelle catégorie de composants, dont certains sont capables de raisonner et d’agir.
L’enjeu n’est pas de transformer tout son système d’information pour accueillir l’IA, mais de déterminer où elle apporte une réelle valeur et comment l’intégrer proprement dans l’existant. C’est ce qui rend le rôle de l’architecte SI plus central que jamais. Il doit positionner l’IA au bon endroit, en mesurer les impacts et donner à la DSI une vision claire de ce qu’elle engage.
C’est à cette condition qu’un projet IA peut passer du POC prometteur à un service fiable en production, capable d’évoluer avec les besoins de l’entreprise. Chez Eleven Labs, nos architectes SI et nos experts certifiés Claude Architect accompagnent les entreprises dans cette démarche, de l‘identification des cas d’usage jusqu’à la conception et l’industrialisation de solutions IA intégrées à leur système d’information.
Vous souhaitez intégrer l’IA à votre système d’information ?
Nos architectes SI et experts IA vous accompagnent pour intégrer l’IA à votre existant, de la conception à la mise en production.