Agence spécialisée en Data Engineering : bâtissez des fondations solides pour vos projets Data
Votre entreprise produit et collecte des données partout. CRM, ERP, applications métier, plateformes e-commerce, outils marketing, services cloud… Les sources se multiplient, les volumes augmentent et les flux de données deviennent de plus en plus complexes à maîtriser. Pourtant, au moment de les exploiter, les difficultés apparaissent : données dispersées, pipelines peu fiables, traitements chronophages, problèmes de qualité et systèmes qui communiquent difficilement. Autant de freins qui limitent la capacité de vos équipes à tirer pleinement parti de leurs données.
C’est précisément là qu’intervient notre agence Data Engineering. Notre rôle est de concevoir, développer et industrialiser les infrastructures et les pipelines qui permettent de collecter, transformer, centraliser et rendre accessibles vos données. L’objectif n’est pas simplement de faire circuler de l’information d’un système à un autre, mais de construire une architecture data cohérente, performante et adaptée aux besoins réels de votre organisation.
De la conception d’architectures data à la mise en place de pipelines ETL/ELT, en passant par l’intégration de vos sources, l’automatisation des flux, la qualité des données et le déploiement de plateformes Data Lake ou Data Warehouse, nos experts Data Engineers interviennent sur l’ensemble de votre chaîne de traitement. Nous nous appuyons sur les technologies adaptées à votre environnement pour construire des solutions fiables, maintenables et capables d’accompagner l’évolution de vos usages, qu’il s’agisse de Business Intelligence, d’analytique avancée ou d’intelligence artificielle.
Chez Eleven Labs, nous abordons le Data Engineering comme un véritable enjeu d’ingénierie logicielle. Nos équipes associent expertise data, maîtrise du cloud et bonnes pratiques de développement pour concevoir des plateformes robustes et évolutives. Nous accompagnons les entreprises en France et à l’international, du cadrage technique à la mise en production, avec une approche pragmatique, exigeante et orientée résultats.
Ils nous font déjà confiance


Une expertise Data Engineering au service de vos enjeux métier
Vous avez des données, mais vous ne savez pas par quoi commencer ? Votre organisation jongle entre ERP, CRM, fichiers Excel et outils dispersés ? Vous manquez de visibilité ou de fiabilité pour exploiter réellement vos données ? Ce sont des situations que l’on rencontre souvent sur le terrain. Le succès ne repose pas sur un algorithme miracle, mais sur une approche Data-by-Design, ancrée dans la réalité de votre organisation, soutenue par une gouvernance des données, des standards de sécurité, et une adoption progressive par les utilisateurs.
En tant qu’agence de conseil et d’ingénierie web & IA, on agit comme un partenaire de confiance capable de transformer votre base de données en levier de performance.
Nos experts Data Engineers développent des pipelines de données robustes, connectent vos différentes sources, automatisent les processus d’ingestion et de transformation et mettent en place des architectures adaptées à vos besoins : Data Lake, Data Warehouse, Lakehouse ou plateformes cloud-native. Et quand le contexte s’y prête, on peut aller plus loin avec des briques IA : algorithmes prédictifs, assistants métiers, intégration de modèles LLM ou Deep Learning.
Chaque projet est cadré, documenté, piloté en transparence, avec un souci constant de qualité et d’efficacité. Nos experts pluridisciplinaires (data engineers, ML engineers, architectes, consultants fonctionnels) accompagnent depuis nos bureaux en France et à l’international, des entreprises de toutes tailles, sur des projets à haute valeur technologique.
De la conception de votre architecture data à l’industrialisation de vos pipelines, nous vous accompagnons à chaque étape pour transformer vos données dispersées en un socle fiable, performant et évolutif.
Évaluation de la maturité Data
Avant de lancer un projet stratégique, il faut savoir d’où on part. On réalise un audit complet de vos données, de votre environnement technologique et de votre organisation interne. Cette évaluation permet d’identifier les opportunités prioritaires, les leviers d’optimisation et les freins à lever pour bâtir une démarche data-driven durable.
Stratégie Data
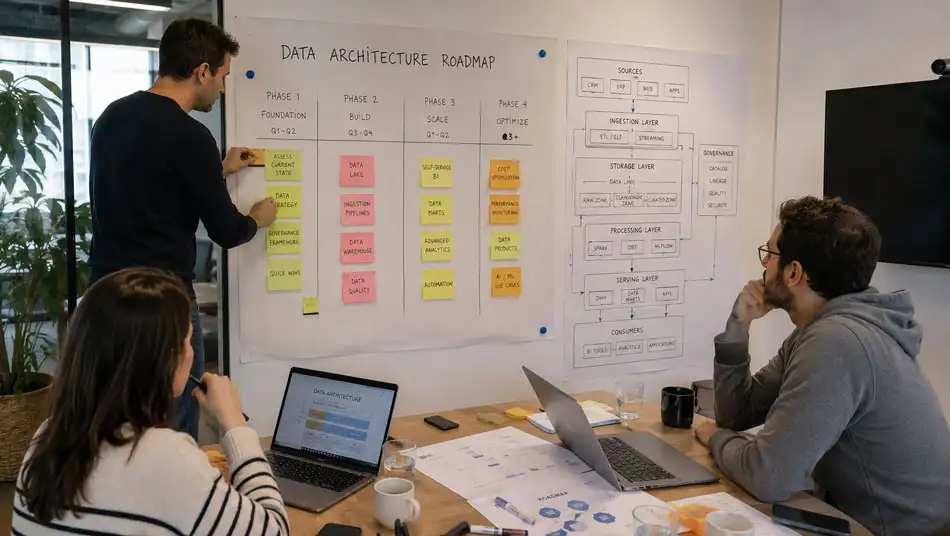
On vous aide à construire une feuille de route data claire, réaliste et actionnable. Ensemble, on priorise les cas d’usage, on identifie les données à activer, les outils à mobiliser et les conditions de succès à réunir. La roadmap s’adapte à votre niveau de maturité, à vos contraintes et stratégies cloud ou métiers, et à vos objectifs business. Elle sert de socle à vos décisions stratégiques.
Structuration des données : collecter, fiabiliser, rendre exploitable
On consolide vos sources, on nettoie la donnée, on transforme la donnée pour la rendre exploitable dans vos applications, dashboards ou futurs modèles IA. Cette étape garantit une base saine, cohérente et traçable. On traite les silos, les formats incohérents, les doublons, et on prépare vos flux pour la suite du projet.
Architecture Data centric scalable avec l’IA
On conçoit une architecture orientée données, pensée dès le départ pour supporter l’intégration de l’intelligence artificielle. Que vous soyez sur un Data Lake, un Data Warehouse, un Lakehouse ou une architecture Delta Lake ou Data Mesh, on choisit les bons composants pour assurer robustesse, sécurité et scalabilité. L’infrastructure posée est directement IA ready : pas besoin de tout revoir quand vous passerez à l’échelle. Elle est conçue pour absorber la complexité sans se déformer.
Pipelines de données : automatiser et orchestrer vos flux multi-source
On développe des pipelines robustes pour faire circuler les données entre vos outils, plateformes, produits et applications. Ces flux sont pensés pour fonctionner en continu, avec monitoring, supervision, versioning, et reprise sur erreur des pipelines. Chaque pipeline devient un maillon essentiel dans votre stratégie d’automatisation et de valorisation des données.
Création de dashboards de visualisation de la donnée
On construit des interfaces de pilotage sur mesure pour exposer les bons indicateurs, au bon moment. Ces dashboards s’appuient sur vos flux temps réel et vous permettent de prendre des décisions éclairées, en toute autonomie.
Adoption de l’IA et formation des équipes
On conçoit des programmes d’acculturation et de formation ciblée pour embarquer vos équipes dans la démarche. Ateliers, accompagnement, documentation : on favorise une culture data-driven et une organisation augmentée par l’IA. Le but, c’est que vos collaborateurs comprennent, adhèrent et utilisent concrètement les outils mis en place.
Amélioration continue
Notre travail ne s’arrête pas au déploiement. On vous accompagne dans une démarche d’amélioration continue, en suivant les performances des modèles dans le temps. On analyse les KPIs clés, on identifie les points de friction, on ajuste les algorithmes si besoin. Cette boucle de feedback garantit que vos systèmes deviennent plus intelligents, précis et toujours alignés avec vos priorités métier.
« La véritable intelligence de la donnée réside dans sa capacité à incarner votre métier. Celui qui s’arrête à la technique en ignore la portée. »
Quels sont les prérequis pour mettre en place une stratégie de gouvernance des données dans son entreprise ?
Impossible de valoriser la donnée sans la maîtriser. Avant d’envisager dashboards, automatisation ou IA, il faut s’assurer que les bases sont solides. Mettre en place une gouvernance data, ce n’est pas juste choisir un outil ou écrire un process, c’est structurer l’ensemble de l’entreprise pour fiabiliser, sécuriser et exploiter les données de manière cohérente.
Les prérequis :
- Avoir une vision claire des données clés pour l’entreprise
- Disposer d’une architecture technique adaptée et évolutive
- Aligner les équipes : IT, Data, Métier doivent avancer ensemble
- Identifier les rôles : qui est responsable, qui contrôle, qui utilise
- Accepter que la gouvernance est progressive et s’inscrit dans la durée
Nos experts sont disponibles pour en discuter avec vous.
Les technologies utilisées par notre agence de data engineering

Python
Langage incontournable du traitement de la donnée et du machine learning, Python est au cœur de la majorité de nos développements IA et pipelines data. Flexible, lisible, puissant.

Scala
Scala est notre langage de prédilection pour développer des applications de streaming temps réel avec Kafka. Statique, fonctionnel et hautement performant, il s’intègre parfaitement dans des architectures distribuées exigeantes. On l’utilise pour concevoir des traitements scalables, des flows événementiels et des pipelines robustes sur des données en mouvement.
Apache Spark
Spark nous permet de traiter des volumes massifs de données en distribué. Parfait pour accélérer les calculs, paralléliser les traitements et industrialiser vos flux à grande échelle.

Snowflake
Moderne, performant, cloud-native : Snowflake est l’un des meilleurs entrepôts de données actuels. Il facilite l’exploitation, le partage et l’interrogation rapide de vos datasets.
Kafka
Kafka est la colonne vertébrale de nos architectures de streaming. On l’utilise pour gérer les flux temps réel, synchroniser les microservices, absorber des pics de charge ou alimenter des systèmes analytiques. Il permet de construire des pipelines robustes, scalables et résilients.

Airflow
Orchestration des workflows, planification des tâches, supervision des traitements : Airflow est notre outil de prédilection pour automatiser et fiabiliser vos pipelines data.

Databricks
Plateforme unifiée pensée pour la data et le machine learning, Databricks combine data engineering, traitement distribué, visualisation et modèles IA. On s’appuie sur son architecture Lakehouse pour concevoir des pipelines scalables et collaboratifs, compatibles avec vos enjeux d’exploitation et de gouvernance.

dbt
Avec dbt, on structure la transformation des données directement dans l'entrepôt analytique. On modélise en SQL, on versionne, on teste et on documente. C’est l’outil parfait pour industrialiser vos transformations en toute transparence et garder la maîtrise sur la logique métier des datasets.

NoSQL
Pour des cas où les données sont semi-structurées, non normalisées ou massives, on s’appuie sur des bases NoSQL comme DynamoDB, MongoDB ou Cassandra. Elles permettent de répondre aux besoins de scalabilité, de disponibilité et d’agilité des systèmes distribués modernes.

SQL
Langage fondamental de la data, SQL reste au cœur de nos pratiques pour interroger, transformer et structurer efficacement vos bases relationnelles. On l’utilise aussi bien pour la modélisation analytique que pour l’audit de qualité de données ou la préparation de reporting.
LLM (OpenAI, Claude, Mistral, Gemini)
On s’appuie sur plusieurs modèles de langage (GPT, Claude, Mistral, Gemini…) pour concevoir des systèmes IA sur mesure : assistants métier, agents de recherche documentaire, enrichissement de données ou génération de contenu structuré. Chaque LLM est sélectionné en fonction du cas d’usage, du besoin de contrôle et du niveau de personnalisation requis.
TensorFlow
Pour le deep learning et les modèles complexes, TensorFlow offre puissance et flexibilité. On l’utilise pour entraîner, tester et déployer des modèles à grande échelle.
MLflow
On utilise MLflow pour piloter tout le cycle de vie des modèles IA : suivi des expérimentations, versioning des artefacts, packaging, déploiement et monitoring. Cet outil est central dans notre approche MLOps pour fiabiliser les mises en production et favoriser l’amélioration continue.

Mastra
On utilise Mastra pour concevoir et orchestrer des agents IA et des workflows métier complexes. Il nous permet de structurer la logique, gérer la mémoire, connecter des outils et faire évoluer facilement un prototype vers un système robuste en production.

OpenRouter
On utilise OpenRouter pour accéder à plusieurs modèles de langage via une API unique. Cela nous permet de comparer, router et optimiser les performances en fonction des cas d’usage, tout en gardant une flexibilité maximale sur le choix des modèles.
Langfuse
On utilise Langfuse pour monitorer et analyser les performances des applications IA en production. Suivi des appels, des coûts, des latences, évaluation des réponses : tout est tracé pour améliorer en continu la qualité et la fiabilité des systèmes déployés.
Les fournisseurs cloud à qui nous faisons confiance
AWS (Amazon Web Services)
Google Cloud Platform (GCP)
Microsoft Azure

Scaleway

OVH Cloud
Pourquoi choisir notre agence data pour votre projet ?
Chez Eleven Labs, agence de conseil et d’ingénierie web & IA, on considère que la donnée et l’intelligence artificielle ne créent de la valeur que si elles s’intègrent naturellement dans l’organisation. Pas comme un outil posé à côté, mais comme une extension logique des processus métiers, utile pour les équipes et concrète dans le quotidien.
Vous travaillez avec des data engineers et IA engineers seniors, certifiés Claude Architect Foundations, qui ont déjà mené des projets dans des contextes variés (ETI, grands groupes, scale-ups). Ils savent cadrer un besoin métier, construire une architecture data stable, développer des modèles IA adaptés en définissant la meilleure architecture (mono-agents ou multi-agents), les connecter à vos systèmes, et surtout les déployer en production. Pas de théorie hors-sol, pas de promesse abstraite : on avance avec les contraintes du terrain.
Notre Lab IA interne permet d’aller plus loin quand c’est pertinent. On y conçoit des agents IA métier (agents conversationnels, automatisations internes, assistants décisionnels, workflows de productivité, support SAV…) et des solutions basées sur des LLM et des approches RAG pour exploiter efficacement vos données. Grâce au Model Context Protocol (MCP), ces agents peuvent se connecter directement à vos applications, API, bases de données ou outils métiers existants, sans ajouter de complexité inutile.
On ne pousse pas une stack à la mode. On choisit les briques qui font sens pour votre contexte, votre maturité, vos contraintes et votre rythme.
Ils nous font confiance pour répondre à leurs enjeux Data
Nous répondons à vos questions les plus fréquentes sur la Data en entreprise
Qu'est-ce que le Data Engineering et à quoi sert-il en entreprise ?
Le Data Engineering regroupe les pratiques et technologies permettant de collecter, transformer, stocker et rendre exploitables les données d’une entreprise. Son objectif est de construire des infrastructures et des pipelines de données fiables pour alimenter les applications métier, les outils de Business Intelligence, les plateformes analytiques et les projets d’intelligence artificielle. Il constitue le socle technique indispensable pour garantir la disponibilité, la qualité et la circulation des données au sein du système d’information.
Pourquoi faire appel à une agence spécialisée en Data Engineering ?
Faire appel à une agence Data Engineering permet de bénéficier d’expertises techniques pour concevoir, développer et industrialiser vos infrastructures de données. Contrairement à une approche limitée au déploiement d’un outil, une agence spécialisée prend en compte votre architecture existante, vos contraintes d’intégration, vos volumes de données et vos objectifs métier. Chez Eleven Labs, nos Data Engineers vous accompagnent dans la conception de solutions robustes, évolutives et maintenables, adaptées à votre environnement technologique.
Quels types de projets peut prendre en charge une agence Data Engineering ?
Une agence Data Engineering intervient sur l’ensemble de la chaîne de traitement des données : création et optimisation de pipelines ETL/ELT, intégration de sources de données, conception de Data Lakes et Data Warehouses, migration de plateformes data vers le cloud, automatisation des flux et mise en place de dispositifs de contrôle de la qualité des données. Elle peut également moderniser une infrastructure existante, améliorer les performances des traitements ou industrialiser des pipelines pour répondre à de nouveaux besoins analytiques et métier.
Quelle est la différence entre un Data Lake et un Data Warehouse ?
Un Data Lake permet de centraliser de grands volumes de données structurées, semi-structurées ou non structurées, souvent dans leur format d’origine. Il est particulièrement adapté aux besoins de stockage à grande échelle et aux traitements exploratoires. Un Data Warehouse est conçu pour organiser et exploiter des données structurées et transformées, notamment pour le reporting et la Business Intelligence. Le choix dépend de vos usages, de vos contraintes et de votre architecture existante. Une architecture Lakehouse peut également combiner certaines caractéristiques des deux approches.
Comment connecter et centraliser les données provenant de plusieurs outils et applications ?
La centralisation des données repose sur la mise en place de pipelines d’ingestion et d’intégration capables de communiquer avec vos différentes sources : ERP, CRM, bases de données, applications métier, API ou services cloud. Les données sont ensuite extraites, transformées et acheminées vers une plateforme centralisée, comme un Data Warehouse ou un Data Lake. Nos Data Engineers conçoivent ces flux en tenant compte de vos contraintes de sécurité, de performance et de fréquence de mise à jour, afin de garantir une circulation fiable des informations.
Comment garantir la qualité et la fiabilité des pipelines de données ?
La fiabilité d’un pipeline repose sur plusieurs bonnes pratiques : tests automatisés, contrôles de qualité des données, monitoring, gestion des erreurs, traçabilité et alertes en cas d’anomalie. L’objectif est de détecter rapidement les problèmes, de limiter les interruptions et d’éviter la propagation de données incorrectes vers les systèmes consommateurs. Chez Eleven Labs, nous appliquons les principes de l’ingénierie logicielle et du DataOps pour concevoir des pipelines maintenables, observables et adaptés aux exigences de production.
Quelles technologies utilisez-vous pour vos projets de Data Engineering ?
Le choix de la stack technologique dépend de votre environnement existant, des volumes de données à traiter et de vos besoins fonctionnels. Nos Data Engineers interviennent notamment sur des technologies comme Python, Apache Spark, Apache Airflow, Kafka, Google BigQuery et les services cloud AWS, Azure ou Google Cloud, selon les compétences mobilisées et le contexte du projet. Nous privilégions des solutions adaptées à votre architecture, capables de s’intégrer à vos outils et de répondre durablement à vos besoins de performance et de maintenabilité.
Combien de temps faut-il pour mettre en place un projet de Data Engineering ?
La durée d’un projet de Data Engineering dépend de plusieurs facteurs : le nombre de sources à intégrer, la complexité des transformations, les volumes de données, l’état de l’infrastructure existante et les exigences de sécurité ou de disponibilité. Un premier pipeline peut être développé en quelques semaines, tandis que la construction ou la modernisation d’une plateforme data complète nécessite généralement plusieurs mois. Chez Eleven Labs, nous privilégions une approche progressive, avec un cadrage initial, des livraisons incrémentales et une industrialisation adaptée à vos priorités métier.
Et si vos projets allaient plus loin que la Data ?
Le Data Engineering constitue le socle de nombreux projets technologiques, mais la valorisation de vos données ne s’arrête pas à leur collecte et à leur transformation. Chez Eleven Labs, nous mobilisons nos expertises complémentaires en architecture data, développement web sur mesure, intelligence artificielle et DevOps pour concevoir des solutions capables de s’intégrer durablement à votre système d’information. De la structuration de vos architectures à l’exploitation de vos données dans des applications métier et des agents IA, nous vous accompagnons sur l’ensemble de vos enjeux techniques.
On vous montre comment on peut transformer vos idées en livrables concrets.
Découvrez nos articles autour des architectures data & IA
- Architecture Data et IA
- 23 min de lecture
- Architecture Data et IA
- 13 min de lecture
- Architecture Data et IA
- 13 min de lecture